LLM open source: 12 nhóm model mở, giấy phép và cách chọn
Phân biệt open source và open weight; cập nhật 12 nhóm model mở, giấy phép, hạ tầng và cách chọn theo nhu cầu.
LLM mở cho phép tải trọng số để tự triển khai, tùy chỉnh và tích hợp vào ứng dụng. Tuy nhiên, tải được model không đồng nghĩa với mã nguồn mở đầy đủ hoặc được dùng thương mại không điều kiện. Bài viết phân biệt các mức độ mở, giới thiệu 12 nhóm model đáng chú ý và cách lựa chọn theo công việc, phần cứng, chi phí.
Bạn có thể bắt đầu với local model, xem các công cụ chạy AI trên máy, hoặc dùng API LLM khi chưa có GPU. danh sách dưới đây không phải thứ hạng chất lượng.
LLM open source là gì?
Trong cách gọi phổ biến, LLM open source chỉ các mô hình ngôn ngữ có trọng số công khai để người dùng tải và vận hành. Bạn có thể chạy trên máy cá nhân, máy chủ GPU hoặc hạ tầng đám mây, thay vì chỉ truy cập ứng dụng của hãng. Việc tinh chỉnh và phân phối lại còn phụ thuộc giấy phép của đúng checkpoint.
Phân biệt mã nguồn mở, trọng số mở và model đóng
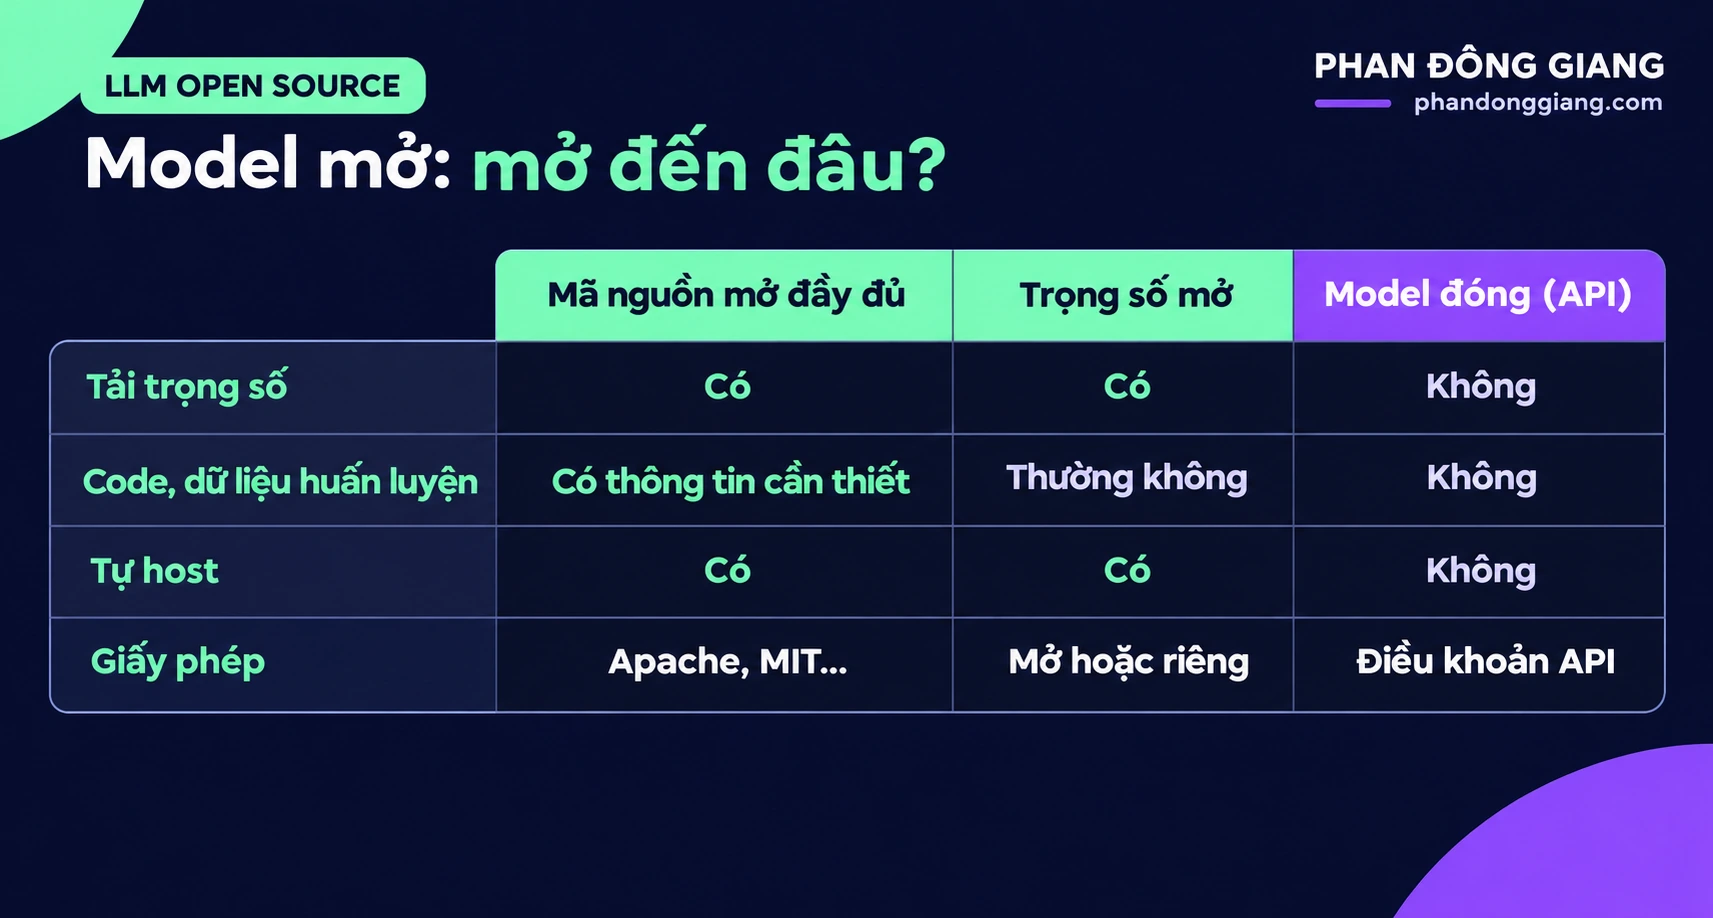
Một hệ thống AI có nhiều thành phần: kiến trúc, trọng số, mã huấn luyện, mã suy luận và thông tin dữ liệu. Mức độ công bố các thành phần này quyết định bạn có thể nghiên cứu và thay đổi hệ thống tới đâu.
- Mã nguồn mở đầy đủ: có quyền sử dụng, nghiên cứu, sửa đổi và chia sẻ, cùng các thành phần cần thiết để thực hiện những quyền đó.
- Trọng số mở — open weight: trọng số tải được; mã huấn luyện hoặc thông tin dữ liệu có thể chưa đầy đủ. Một số giấy phép giới hạn lĩnh vực hay quy mô thương mại.
- Model đóng: truy cập qua ứng dụng hoặc API; không được tải checkpoint để tự host.
Theo Open Source AI Definition của OSI, yêu cầu về dữ liệu là thông tin đủ chi tiết để có thể xây hệ thống tương đương đáng kể; không nên diễn giải thành mọi bộ dữ liệu thô đều phải công khai. Đồng thời, việc gắn nhãn Apache-2.0 cho trọng số riêng lẻ chưa tự chứng minh toàn bộ hệ thống đáp ứng định nghĩa này.
Vì sao model mở được quan tâm?
- Dữ liệu: có thể giữ khâu suy luận và tài liệu nội bộ trong hạ tầng do mình quản lý.
- Triển khai: chủ động chọn máy chủ, lịch cập nhật và nhà cung cấp vận hành.
- Tùy chỉnh: có thể fine-tune hoặc kết hợp RAG khi giấy phép và công cụ hỗ trợ.
- Chi phí: chuyển một phần chi phí theo token sang GPU, điện, lưu trữ và nhân sự.
- Tích hợp: kết nối chatbot, tác vụ tự động và agent theo kiến trúc riêng.
- Ngoại tuyến: một số model nhỏ có thể sử dụng sau khi đã tải đủ tài nguyên.
Tự host vẫn có chi phí và công việc bảo trì. Model miễn phí tải về có thể đắt hơn API nếu phần cứng ít được sử dụng hoặc đội vận hành chưa sẵn sàng. Xem ưu nhược điểm của model miễn phí và cách chọn LLM tiết kiệm cho Hermes Agent.
Đọc benchmark trước khi chọn model
Benchmark đo một nhóm năng lực trong điều kiện cụ thể. Điểm cao ở câu hỏi học thuật không trực tiếp chứng minh model xử lý tốt dữ liệu nội bộ, tiếng Việt hay chuỗi công cụ của bạn.
- HLE, GPQA Diamond: câu hỏi học thuật và suy luận khoa học khó.
- SWE-bench: sửa lỗi phần mềm trong repository; cần đọc rõ tập dữ liệu và agent scaffold.
- OSWorld: tác vụ thao tác giao diện máy tính.
- BrowseComp: tìm kiếm và tổng hợp thông tin khó trên web.
- Terminal-Bench: tác vụ nhiều bước trong môi trường terminal.
- ARC-AGI: suy luận với bài toán trừu tượng; phiên bản và cách chấm phải được nêu rõ.
Khi tham khảo Artificial Analysis, SWE-bench hay Epoch AI, hãy ghi ngày xem, phiên bản model và mức suy luận. Bài so sánh model theo benchmark có bảng cập nhật riêng. Lượng sử dụng trên OpenRouter là một chỉ số khác, không phải điểm thông minh.
12 nhóm model trọng số mở đáng chú ý trong tháng 11/2026
Bảng này tách checkpoint tải được khỏi tên model trên API. Đặc biệt, Kimi K3.1 Pro và Mistral Large 4 đã có trọng số; trong khi Qwen4-Max xuất hiện trong danh mục API chưa phải bằng chứng Qwen4 đã được mở trọng số.
| Dòng model | Trọng số đáng chú ý | Giấy phép cần kiểm tra | Hạ tầng |
|---|---|---|---|
| GLM | GLM-5.3; GLM-5.3-Flash | 5.3: riêng; Flash: MIT | Cụm GPU hoặc API |
| Kimi | Kimi-K3.1-Pro | Kimi K3.1-Pro License | Cụm GPU hoặc API |
| MiniMax | M3; M3.1-Flash | MiniMax Community License | Cụm GPU hoặc API |
| DeepSeek Pro | V4-Pro-0813 | MIT | Cụm GPU hoặc API |
| DeepSeek Flash | V4.1-Flash-1017 | MIT | Cụm GPU hoặc API |
| NVIDIA Nemotron | Dòng 3 và 3.5 | Theo checkpoint: Nemotron/OpenMDW | Theo kích thước |
| Qwen | Qwen3.8-27B; Max; Flash-Next | 27B: Apache-2.0; Max/Flash-Next: riêng | Một máy tới cụm GPU |
| Mistral | Mistral Large 4; Large 3 | Large 4: riêng; Large 3: Apache-2.0 | Cụm GPU hoặc API |
| Gemma | Gemma 4 | Apache-2.0 | Máy cá nhân tới máy chủ |
| Llama | Llama 4 Scout, Maverick | Llama 4 Community License | Hạ tầng nhiều bộ nhớ |
| Gpt-oss | 120b, 20b | Apache-2.0 | Theo cỡ và lượng tử hóa |
| DeepSeek-R1 | R1 và các bản Distill | Đọc cả giấy phép model nền khi dùng Distill | Tùy checkpoint |
1. GLM-5.3 và GLM-5.3-Flash
GLM của Z.ai hướng tới suy luận, lập trình và agent dùng công cụ. Bản đầy đủ và bản Flash cần được xem là hai checkpoint riêng khi đánh giá chất lượng, bộ nhớ và điều kiện triển khai.
GLM-5.3 dùng giấy phép riêng; GLM-5.3-Flash dùng MIT. Không nên lấy giấy phép MIT của GLM-5.2 rồi áp cho toàn bộ dòng mới. Model lớn phù hợp hơn với cụm GPU hoặc dịch vụ API.
Đọc tiếp: GLM là gì?.
2. Kimi K3.1 Pro
Kimi của Moonshot AI tập trung vào tác vụ dài, lập trình và agent. Tính đến lần rà soát này, Kimi-K3.1-Pro đã có trọng số tải về, thay cho nhận định cũ rằng bản này chỉ tồn tại trên API.
Model card nêu quy mô 2,8 nghìn tỷ tham số, 104 tỷ kích hoạt và context 1 triệu token. Giấy phép K3.1-Pro có điều kiện thương mại và ghi nhận nguồn; người cung cấp dịch vụ model cần đọc đúng điều khoản. Tự chạy bản đầy đủ đòi hỏi hạ tầng lớn.
Đọc tiếp: Kimi AI là gì?.
3. MiniMax M3 và M3.1-Flash
MiniMax có các model phục vụ lập trình, suy luận và tác vụ agent. M3.1-Flash là lựa chọn cần xem cùng M3 khi cân nhắc độ trễ và chi phí, không nên gộp model ngôn ngữ với các sản phẩm tạo ảnh hoặc video của hãng.
Model card MiniMax và giấy phép cộng đồng đi kèm quy định việc dùng thương mại, phân phối và ghi nhận nguồn. MiniMax M3.1 không mặc nhiên là MIT. Hạ tầng tự host vẫn cần dự toán theo toàn bộ trọng số và context.
Đọc tiếp: MiniMax là gì?.
4. DeepSeek V4 Pro
DeepSeek-V4-Pro-0813 là checkpoint Pro hiện hành được đối chiếu. Đây là model MoE lớn phục vụ các tác vụ suy luận, code và agent phức tạp.
Giấy phép là MIT. Bản Pro và Flash có sự đánh đổi về chi phí, tốc độ và chất lượng; hãy kiểm tra danh mục API DeepSeek cùng tác vụ thực tế thay vì mặc định Pro tốt hơn trong mọi trường hợp.
Đọc tiếp: Các model của DeepSeek.
5. DeepSeek V4.1 Flash
DeepSeek-V4.1-Flash-1017 là bản Flash ngày 17/10/2026, tiếp tục hiện hành ở. Model dùng MIT và có quy mô lớn hơn nhiều so với những model nhỏ dành cho laptop.
Flash là một ứng viên để thử cho chatbot, RAG và agent cần cân bằng tốc độ với chi phí. Bản tải về và alias API phải được kiểm tra riêng vì nhà cung cấp có thể cập nhật đích của alias.
Đọc tiếp: DeepSeek AI là gì?.
6. NVIDIA Nemotron 3 và 3.5
Nemotron có nhiều kích thước cho suy luận, lập trình và agent. Trong dòng 3, Ultra có quy mô 550 tỷ tham số với 55 tỷ kích hoạt; các model 3.5 mở rộng lựa chọn cho những cấu hình triển khai khác nhau.
Kho chính thức NVIDIA công bố giấy phép theo checkpoint. Nano/Super dòng 3 và Ultra/dòng 3.5 không nên được gộp vào một giấy phép duy nhất. Kiểm tra Nemotron Open Model License hoặc OpenMDW-1.1 ở đúng bản muốn dùng.
Đọc tiếp: NVIDIA Nemotron là gì?.
7. Qwen3.8 và sự khác biệt với Qwen4-Max trên API
Qwen3.8-27B là một checkpoint có thể cân nhắc để tự host với Apache-2.0. Trong cùng thế hệ, Max và Flash-Next có kiến trúc, quy mô và giấy phép khác; không được suy từ bản 27B rằng cả dòng đều Apache-2.0.
Kho Qwen có trọng số 3.8; Model Studio đã liệt kê qwen4-max trong danh mục cập nhật tháng 11. Chưa thấy trọng số Qwen4 chính chủ trong lần kiểm tra, vì vậy bài tách API mới nhất với dòng tải được.
Đọc tiếp: Các model của Qwen.
8. Mistral Large 4 và Large 3
Mistral Large 4 đã có trọng số chính chủ trong tháng 10/2026, nên thông tin cũ “Large 4 chỉ qua API” cần được cập nhật. Large 3 vẫn là một lựa chọn lịch sử hữu ích để so sánh giấy phép và kiến trúc.
Kiểm tra kho Mistral AI và model card của đúng bản: Large 4 dùng giấy phép riêng; Large 3 dùng Apache-2.0. Với các model lớn, tự host thường cần cụm GPU; việc API cũ ngừng phục vụ không đồng nghĩa trọng số biến mất.
Đọc tiếp: Mistral AI là gì?.
9. Gemma 4
Gemma 4 của Google có các cỡ E2B, E4B, 12B, 26B-A4B và 31B, đáp ứng nhu cầu từ thiết bị nhỏ đến máy chủ. Cần đọc modality và context của từng cỡ, không áp thông số bản này cho tất cả các bản khác.
Gemma 4 31B dùng Apache-2.0, khác điều khoản của các thế hệ Gemma trước. Các cỡ nhỏ là điểm bắt đầu phù hợp để thử trên máy cá nhân; bản lớn cần tính thêm bộ nhớ runtime và KV cache.
Đọc tiếp: Gemma 4 là gì?.
10. Llama 4 Scout và Maverick
Llama 4 là dòng model của Meta có hệ sinh thái triển khai và fine-tune rộng. Scout và Maverick dùng kiến trúc MoE; ví dụ Maverick có 17 tỷ tham số kích hoạt nhưng tổng trọng số lớn hơn đáng kể.
Llama 4 trên Hugging Face yêu cầu chấp nhận điều khoản và có thể xét quyền truy cập. Giấy phép cộng đồng của Meta có điều kiện riêng. Không dùng số tham số kích hoạt để suy ra dung lượng tải hay VRAM cần thiết.
Đọc tiếp: Llama của Meta là gì?.
11. gpt-oss-120b và gpt-oss-20b
Gpt-oss là các model suy luận trọng số mở của OpenAI, có function calling, Structured Outputs và mức suy luận điều chỉnh được. Hai cỡ 120b và 20b phục vụ các ngân sách bộ nhớ khác nhau.
Model card gpt-oss nêu giấy phép Apache-2.0. Bản 120b có cấu hình MXFP4 hướng tới GPU 80GB; khả năng chạy thực tế còn phụ thuộc context, framework và tải đồng thời. Đây là dòng model riêng, không phải trọng số của GPT-6.2.
Đọc tiếp: Các model của OpenAI.
12. DeepSeek-R1 và các bản Distill
DeepSeek-R1 là dòng suy luận thế hệ trước nhưng vẫn có giá trị học tập và thử nghiệm. Các bản Distill từ 1.5B tới 70B giúp tiếp cận mô hình suy luận trên nhiều cấu hình nhỏ hơn bản đầy đủ.
Kho DeepSeek-R1 cung cấp model card và thông tin giấy phép. Khi dùng bản Distill, đọc cả điều kiện của model nền Qwen/Llama tương ứng. R1 không phải phiên bản mới nhất của DeepSeek trong tháng 11/2026.
Đọc tiếp: Tổng quan DeepSeek.
Chọn model theo công việc và phần cứng
Hãy bắt đầu với tác vụ, ngân sách, yêu cầu dữ liệu và giấy phép. Sau đó chọn 3–5 ứng viên để đo bằng cùng bộ câu hỏi hoặc workflow; những nhóm dưới đây là danh sách thử, không phải cam kết model nào thắng.
Lập trình và suy luận kỹ thuật
- Có thể thử DeepSeek V4 Pro, GLM-5.3 hoặc Kimi K3.1 Pro cho chuỗi tác vụ code và dùng công cụ.
- Nếu muốn một máy chủ với giấy phép trọng số Apache-2.0, xem Qwen3.8-27B hoặc gpt-oss theo giới hạn phần cứng.
- Đo cả tỷ lệ hoàn thành, số lượt gọi công cụ, thời gian và chi phí để sửa lỗi còn lại.
Agent nhiều bước
- Kimi, GLM và MiniMax là những dòng có thể thử khi cần điều phối công cụ.
- Gpt-oss có thể tự host cho tác vụ tool calling; Nemotron phù hợp để xem xét khi đã có hạ tầng NVIDIA.
- Chạy agent trong môi trường được giới hạn quyền và đánh giá cả lỗi gọi công cụ, không chỉ chất lượng câu trả lời.
Chạy local trên máy cá nhân
- Thử Gemma 4 cỡ nhỏ, gpt-oss-20b hoặc bản Distill nhỏ trước khi tải model lớn.
- Qwen3.8-27B và các checkpoint MoE nhỏ hơn có thể phù hợp với máy nhiều RAM/VRAM, tùy lượng tử hóa.
- Chọn Ollama hoặc LM Studio, rồi kiểm tra tương thích model và dung lượng thực tế.
Chatbot và tìm kiếm tăng cường bằng tài liệu — RAG
- Thử Qwen3.8-27B hoặc Gemma 4 khi cần tự triển khai chatbot đa ngôn ngữ; cân nhắc DeepSeek V4.1 Flash qua API khi ưu tiên tải đồng thời và chi phí.
- Đo riêng chất lượng truy xuất và câu trả lời: tài liệu có được lấy đúng không, trích dẫn có khớp nguồn không, model có biết từ chối khi thiếu dữ liệu không?
- Dùng tài liệu tiếng Việt thực tế để kiểm tra thuật ngữ, bảng, lỗi OCR và câu hỏi nhiều bước; model tốt không tự sửa được mọi lỗi của pipeline retrieval.
Suy luận và toán học
- DeepSeek-R1 Distill có nhiều cỡ phù hợp thử nghiệm; gpt-oss cho phép điều chỉnh mức suy luận theo tác vụ và ngân sách.
- Có thể so sánh thêm DeepSeek V4 Pro hoặc GLM hiện hành khi bài toán cần nhiều bước hoặc dùng công cụ kiểm chứng.
- Chấm kết quả trên cùng bộ đề, prompt và giới hạn tài nguyên; phân biệt lời giải đúng với lời giải dài. Kiểm tra bằng tính toán hoặc mã thực thi khi bài toán cho phép.
Triển khai cho doanh nghiệp
- Đánh giá tiếng Việt, khả năng đọc tài liệu, trích nguồn và độ trễ theo mức tải dự kiến.
- Qwen3.8-27B, Gemma 4 và gpt-oss là những ứng viên có giấy phép trọng số dễ tiếp cận; DeepSeek MIT cần hạ tầng lớn hơn ở bản đầy đủ.
- Mistral Large 3 và Large 4 có điều kiện giấy phép khác nhau; GLM, Kimi, MiniMax và Llama cũng cần đọc đúng checkpoint.
- Doanh nghiệp cần dự toán GPU, điện, lưu trữ, sao lưu, giám sát, cập nhật và người vận hành.
VPS CPU thông thường có thể chạy agent gọi API hoặc model nhỏ; không thể mặc định chạy được checkpoint hàng trăm tỷ tham số. Xem local model và các cách triển khai trước khi chọn hạ tầng.
Những điểm cần kiểm tra trước khi đưa vào sản phẩm
- Ghi đúng model ID, revision, lượng tử hóa và giấy phép đã dùng.
- Phân biệt Base, Instruct, Pro, Flash, Distill và các cấu hình suy luận.
- Tính bộ nhớ từ toàn bộ trọng số, KV cache, context và số yêu cầu đồng thời.
- Kiểm tra chất lượng tiếng Việt, tài liệu thực tế và tình huống sai của dự án.
- Đọc điều kiện thương mại, phân phối lại, attribution và giới hạn theo khu vực/quy mô.
- Kiểm soát quyền chạy lệnh, dữ liệu nhạy cảm và kết nối ra ngoài của runtime.
- Theo dõi cập nhật model, công cụ và giá API để có kế hoạch thử lại.
Câu hỏi thường gặp
Model mở có giúp giữ dữ liệu riêng tư không?
Có thể, nếu toàn bộ tác vụ chạy trong hạ tầng được kiểm soát và không gửi dữ liệu qua API, telemetry hay công cụ bên ngoài. Nguồn gốc quốc gia của model không thay thế việc kiểm tra kiến trúc triển khai, quyền truy cập và luồng dữ liệu.
Máy cá nhân cần cấu hình như thế nào?
Tùy checkpoint và context. Model vài tỷ tham số hoặc bản lượng tử hóa nhỏ có thể chạy trên máy cá nhân; cỡ 20–30B cần nhiều RAM/VRAM hơn; các bản hàng trăm tỷ thường cần hạ tầng chuyên dụng. CPU vẫn có thể chạy một số bản nhỏ nhưng thường chậm hơn. Xem công cụ chạy local để bắt đầu.
Dùng thương mại có miễn phí không?
MIT và Apache-2.0 thường cho quyền sử dụng rộng nhưng vẫn có nghĩa vụ thông báo hoặc giữ giấy phép. Các giấy phép riêng có thể thêm điều kiện kinh doanh, phân phối, khu vực và quy mô. Cần đọc LICENSE của bản tải về; phí giấy phép model và chi phí vận hành là hai khoản khác nhau.
Có thể chỉ dựa vào benchmark để quyết định không?
Benchmark hữu ích để lọc ứng viên. Quyết định triển khai cần đo trên dữ liệu thật, cùng prompt, công cụ và ngân sách. Đừng so điểm khác bộ test hoặc lấy thứ hạng lượng sử dụng làm thứ hạng chất lượng.
Tải model ở đâu?
Hugging Face là nơi phổ biến để xem model card, LICENSE và checkpoint chính chủ. Một số công cụ còn có danh mục hoặc định dạng chuyển đổi riêng. Hãy kiểm tra người phát hành, revision và nguồn của bản lượng tử hóa.
Từ danh sách model tới lựa chọn triển khai
Model mở giúp bạn chủ động hơn về dữ liệu, tùy chỉnh và hạ tầng. Giá trị của lựa chọn nằm ở việc đáp ứng công việc với tổng chi phí hợp lý. Trước khi triển khai, hãy kiểm tra lại model card, giấy phép và thử nghiệm trên dữ liệu của chính bạn.