Ollama: cài model local, dùng CLI và kết nối API với ứng dụng
Hướng dẫn Ollama trên máy riêng, phân biệt local/cloud, chọn tag model và bảo vệ endpoint khi nối agent.
Ollama là phần mềm có mã nguồn theo MIT để tải, quản lý và phục vụ model trên máy hoặc server. CLI và API giúp ứng dụng gọi model ở localhost:11434. Nó cũng có lựa chọn cloud, nên cần kiểm model đang dùng chạy ở đâu; cài Ollama không tự biến mọi lời gọi thành inference local.
Bài thuộc cụm chạy local model, trình bày từ cài đặt tới tích hợp. Nếu bạn chỉ cần API hosted, xem các nền tảng cấp key để so chi phí và yêu cầu hạ tầng.
release latest là v 0.40.16, phát hành 09/11. Bản này có cập nhật CUDA 13.5 trên Windows ARM, giảm bộ nhớ cho Qwen 3.8 FlashNext trên Apple Silicon và sửa hành vi API. Yêu cầu máy cần theo docs hiện hành chứ không theo ảnh bộ cài cũ.
Tổng quan về Ollama AI
Ollama gom model storage, nạp trọng số và API serving vào một công cụ. Các lệnh pull/run/list giúp quản lý vòng đời cơ bản, còn runtime xử lý việc dùng CPU/GPU theo cấu hình được hỗ trợ.
Ollama AI là gì?
Thay vì tự ghép nhiều thư viện để thử một checkpoint, bạn có thể chọn tag trong thư viện Ollama rồi tải và chạy. Mỗi model vẫn có kiến trúc, modality và license riêng; đừng coi mọi file GGUF hoặc mọi model mở đều tương thích.
Kho ollama/ollama công khai mã và license MIT. Hệ sinh thái bên ngoài có nhiều ứng dụng kết nối qua API, nhưng tính năng và bảo mật của từng ứng dụng không mặc nhiên được dự án Ollama bảo đảm.
Điều gì làm nên sự đặc biệt của Ollama AI?
Điểm thuận tiện là chuẩn hóa các thao tác thường gặp khi bắt đầu chạy model. Những lợi ích dưới đây giúp giảm cấu hình ban đầu, không xóa các giới hạn phần cứng hoặc nhu cầu kiểm tra model.
Đơn giản hóa việc triển khai LLM
Bộ cài và CLI giúp người dùng lấy checkpoint, quản lý tag và mở server mà ít phải tự xây pipeline inference. Khi model hoặc GPU chưa được hỗ trợ, vẫn cần đọc log và tài liệu thay vì kỳ vọng một lệnh giải quyết mọi tương thích.
Tối ưu hóa hiệu suất phần cứng
Ollama có các backend tăng tốc cho phần cứng được hỗ trợ, gồm NVIDIA, AMD, Apple Metal và các đường hỗ trợ khác tùy hệ điều hành/release. Kiểm bảng hardware theo đúng GPU/driver; không có backend phù hợp có thể chuyển sang CPU với latency khác đáng kể.
Tăng cường quyền riêng tư và bảo mật dữ liệu
Model local có thể giữ inference trên máy, nhưng cloud model gửi request tới dịch vụ hosted. Nếu chính sách yêu cầu tắt cloud, kiểm OLLAMA_NO_CLOUD và cấu hình ứng dụng. Rà cả tool, telemetry và storage trước khi kết luận toàn bộ dữ liệu không ra ngoài.
Linh hoạt và khả năng tùy biến cao
Modelfile cho đặt system prompt, tham số và nhập model theo định dạng được hỗ trợ. Đây là cách đóng gói cấu hình, không đồng nghĩa đã fine-tune trọng số. REST API giúp kết nối ứng dụng, nhưng cần kiểm schema và hành vi của endpoint.
Cộng đồng mã nguồn mở năng động
Mã công khai cho phép xem thay đổi, theo dõi issue và bản vá. Cộng đồng giúp mở rộng tích hợp; khi có lỗi, ghi rõ version runtime, tag/digest model, phần cứng và request đã loại bí mật để tái hiện.
Hỗ trợ đa nền tảng toàn diện
Ollama có bản cho Windows, macOS, Linux và image Docker. Docs Windows nêu Windows 10 22 H 2 trở lên và bộ cài không cần quyền Administrator; chừa thêm dung lượng cho trọng số, không chỉ phần mềm.
Các mô hình của Ollama AI
Thư viện có nhiều họ model và tag theo kích thước/quant. Chọn tag dựa vào bộ nhớ cho cả weights và context, rồi kiểm tốc độ/tính năng; một tên model tồn tại không có nghĩa máy bạn phục vụ được ở cấu hình mong muốn.
- Gemma: kiểm tag, modality và license đúng checkpoint ở bài Gemma.
- Qwen: có nhiều thế hệ và biến thể; xem catalog Qwen để tránh nhầm tag chat/code.
- gpt-oss: các checkpoint mở của OpenAI có nhu cầu bộ nhớ khác nhau; xem model OpenAI.
- DeepSeek: model lớn và bản distilled không cùng cấu hình; đối chiếu model DeepSeek.
- Laguna XS 2.1: model code local được Poolside mô tả có hỗ trợ Ollama; kiểm quant và context trước khi dùng với agent.
Dùng đúng chuỗi tag ở Ollama Library, không tự suy từ tên marketing. Danh sách model mở giúp kiểm license; tag latest có thể thay đổi nên ghi lại digest khi cần tái hiện.
Chi phí sử dụng Ollama AI
Phần mềm local không tính phí inference API cho từng token, nhưng thiết bị và vận hành vẫn có chi phí. Cloud của Ollama có billing riêng, không được gộp với quyền dùng phần mềm mã nguồn mở.
- License phần mềm: Ollama theo MIT; checkpoint tải về có điều khoản riêng.
- Inference local: không có hóa đơn token từ cloud cho phần tính trên máy, nhưng có điện, phần cứng và quản trị.
- Bộ nhớ: model lớn/context dài đòi tài nguyên; quant giảm dung lượng với đánh đổi cần đo.
- Tải liên tục: tính cả điện, làm mát và thời gian máy hoạt động.
- Cloud tùy chọn: kiểm pricing và usage; không mặc định ưu đãi luôn còn.
Nếu đã có máy phù hợp, Ollama là cách thử model tiện lợi. Nếu phải mua máy mới, so tổng chi phí và chất lượng nhiệm vụ với hosted API trước khi đầu tư.
Một số điểm còn hạn chế của Ollama AI
Trước khi dùng cho tải thật, cân nhắc bộ nhớ, tốc độ, concurrency, cập nhật và cách bảo vệ API. Một công cụ dễ cài không đồng nghĩa tự có toàn bộ cơ chế quản trị dịch vụ.
Yêu cầu phần cứng cao
Model cần đủ RAM/VRAM cho weights và cache. Nếu không vừa, runtime có thể offload, chậm hoặc báo lỗi; chọn model nhỏ hơn còn làm thay đổi năng lực nên phải kiểm chất lượng riêng.
Phụ thuộc vào kết nối internet ban đầu để tải mô hình
Sau khi tải đủ phần mềm và checkpoint, inference local có thể không cần mạng. Lần tải đầu vẫn tốn băng thông và đĩa; nên kiểm nguồn, dung lượng và digest khi chuyển model vào môi trường kín.
Tiềm ẩn lỗ hổng bảo mật và thiếu xác thực
Theo FAQ, server mặc định ở loopback 11434. API local không có cơ chế key giống cloud; mở ra mạng mà không kiểm soát có thể cho người khác sử dụng tài nguyên. Dùng auth ở lớp phù hợp, firewall và mạng riêng thay vì phơi cổng công khai.
Khó khăn trong gỡ lỗi và quản lý lỗi
Lỗi tích hợp có thể đến từ model, template, parser, context, backend hoặc ứng dụng gọi. Tách một request tối thiểu để thử trực tiếp API, rồi so log runtime và ứng dụng thay vì quy mọi lỗi về “AI hiểu sai”.
Hạn chế về khả năng mở rộng
Ollama có cấu hình parallelism và scheduling, nhưng throughput phụ thuộc context, model và bộ nhớ. Khi phục vụ nhiều người, benchmark workload thật và so với vLLM hoặc runtime serving chuyên biệt nếu cần; không suy chỉ từ một giá trị mặc định cũ.
Cập nhật mô hình thủ công
Cập nhật ứng dụng và cập nhật checkpoint là hai việc khác nhau. Kiểm cơ chế cập nhật theo OS; sau khi pull một tag mới, chạy lại phép thử vì nội dung tag hoặc backend có thể thay đổi.
Hướng dẫn cài đặt và sử dụng Ollama
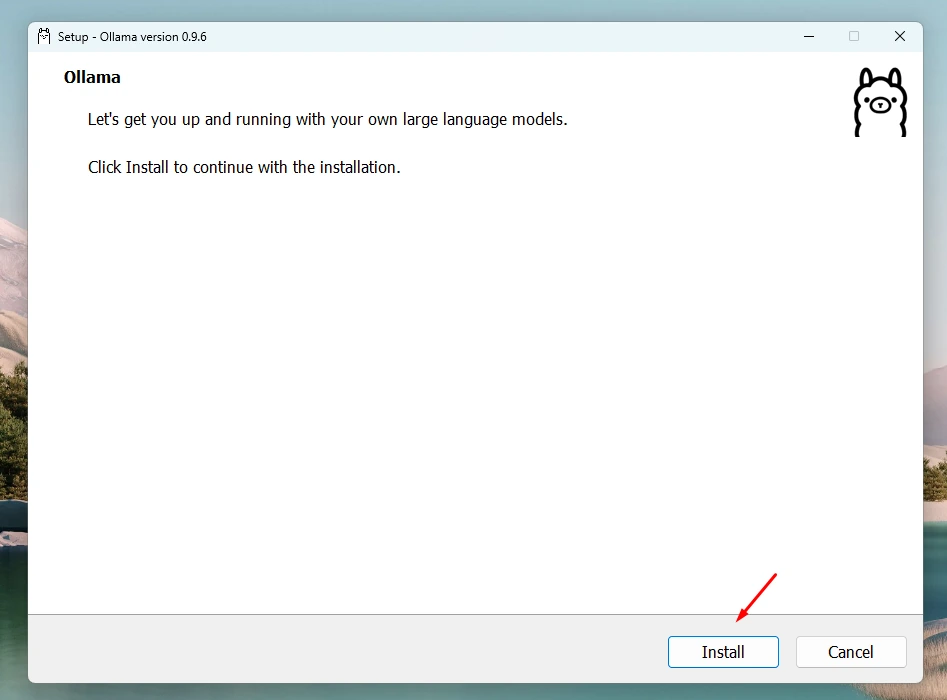
Quy trình cơ bản vẫn là cài phần mềm, xác nhận server, tải model rồi chạy thử. Các ảnh dưới minh họa giao diện cũ, không mô tả bản v 0.40.16; ưu tiên tài liệu và thông báo bộ cài đang dùng.
Tải xuống và cài đặt Ollama
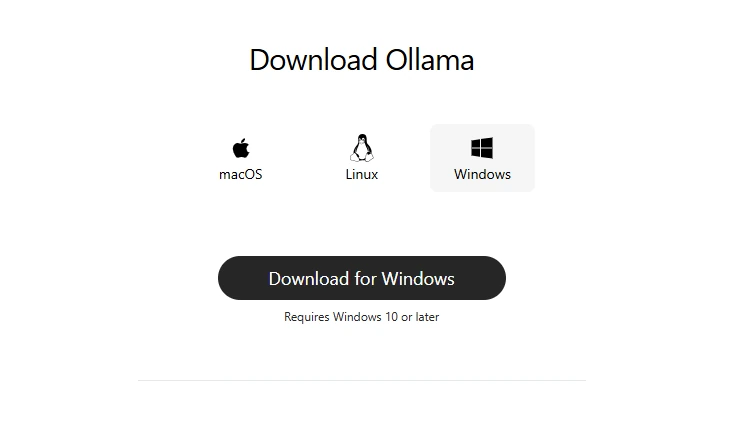
Bước 1: mở trang tải chính thức và chọn hệ điều hành.
Bước 2: tải đúng bộ cài/kiến trúc rồi thực hiện hướng dẫn trên màn hình. Trên Windows, nút Install trong ảnh là ví dụ giao diện; không lấy ảnh làm bằng chứng về version hiện tại.
Sau khi cài, khởi chạy Ollama theo cách của hệ điều hành và kiểm trạng thái tiến trình/server.
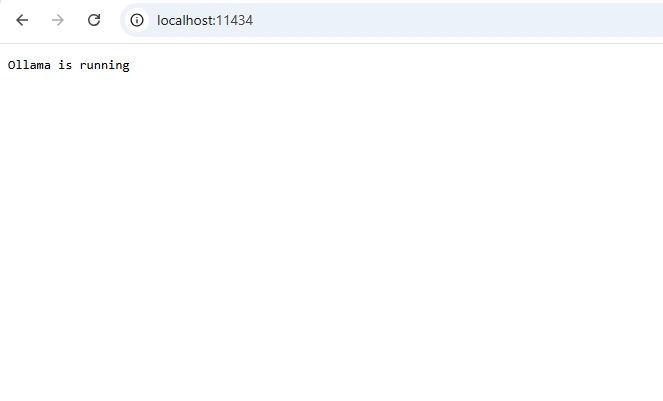
Có thể mở http://localhost:11434 để kiểm phản hồi server. Thông báo đang chạy chỉ xác nhận server sống, chưa chứng minh model đã nạp hoặc GPU đã được dùng.
Bước 3: mở Terminal, PowerShell hoặc Command Prompt để dùng CLI. Chạy lệnh version trước khi gửi báo lỗi.
Ví dụ kiểm phiên bản đang cài:
ollama --version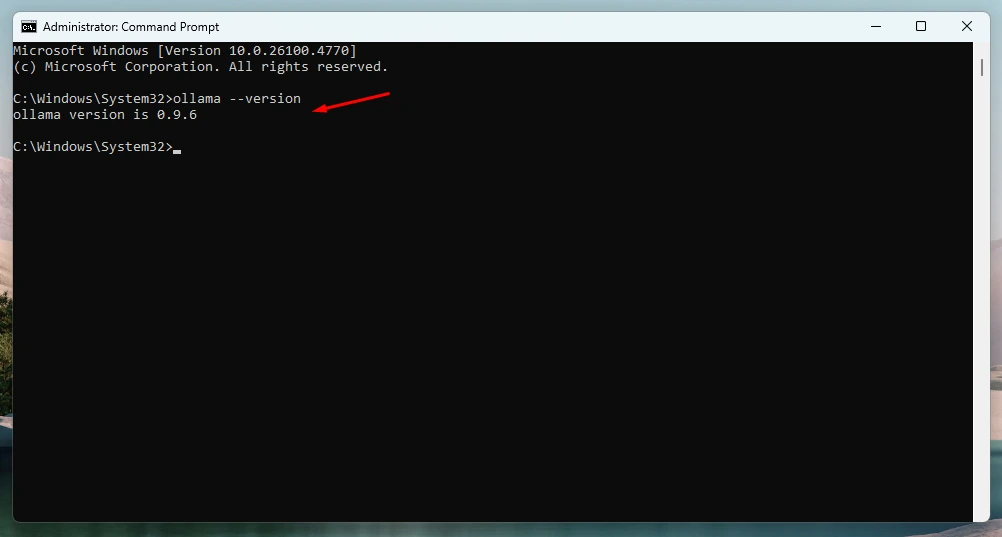
Tải và chạy một mô hình AI
Tải model: ví dụ dưới dùng Gemma 4. Kiểm tag và license ở library trước khi chạy; chọn tag nhỏ phù hợp máy thay vì tải bản lớn theo tên chung.
ollama pull gemma4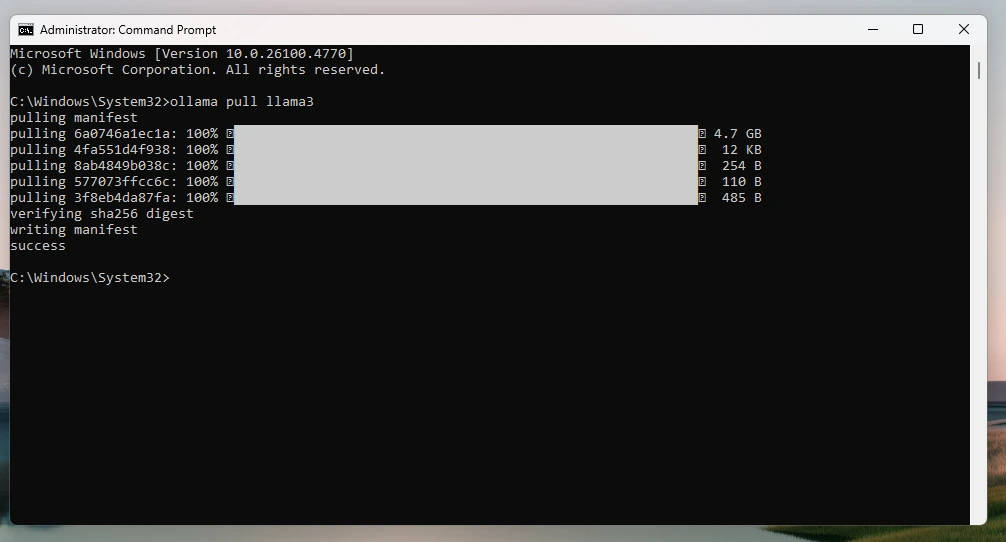
Bắt đầu chat với tag vừa tải:
ollama run gemma4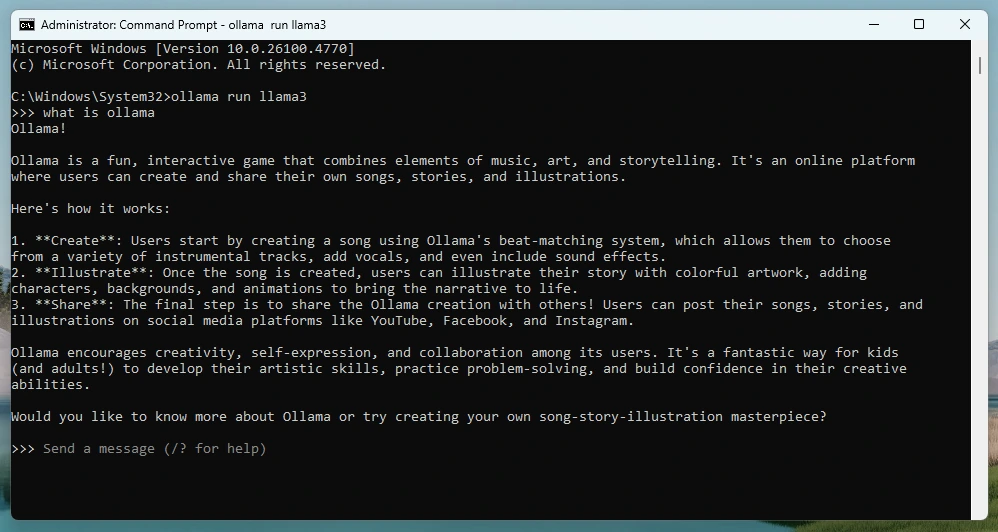
Nhập một câu hỏi ngắn để thử. Nếu model đưa thông tin có vẻ tự tin nhưng sai, đó không phải bằng chứng server lỗi; kiểm lại nội dung bằng nguồn và dùng test cho tác vụ quan trọng. Các ảnh CLI cũ dùng Llama 3 chỉ là minh họa lịch sử.
Thoát phiên hội thoại:
Dùng /bye hoặc phím tắt mà terminal hỗ trợ. Ctrl+C thường dừng phần sinh đang chạy; kiểm prompt trước khi gửi lệnh hệ thống tiếp.
Xem model đã tải:
ollama listCác lệnh quản lý cơ bản:
| Lệnh | Chức năng |
|---|---|
| Ollama run <tên_mô_hình> | Chạy mô hình (tự tải nếu chưa có) |
| Ollama pull <tên_mô_hình> | Tải hoặc cập nhật mô hình |
| Ollama list | Xem danh sách mô hình đã tải |
| Ollama ps | Xem mô hình đang nạp trong bộ nhớ, chạy bằng GPU hay CPU |
| Ollama rm <tên_mô_hình> | Xoá mô hình khỏi máy |
| Ollama create <tên> -f Modelfile | Tạo mô hình tuỳ chỉnh từ Modelfile |
| Ollama serve | Chạy server Ollama khi không dùng ứng dụng nền (thường dùng trên Linux) |
Sử dụng giao diện người dùng web (tùy chọn)
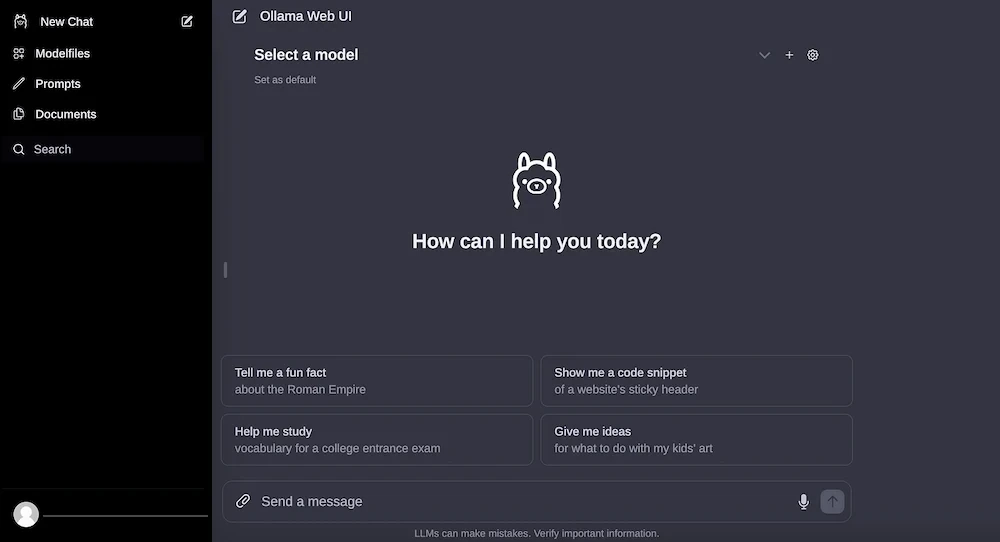
Nếu thích GUI, có thể dùng ứng dụng chat tích hợp Ollama hoặc OpenWebUI. Lớp giao diện quản lý hội thoại và kết nối server, không tự thay đổi năng lực hoặc bộ nhớ model.
Cài OpenWebUI theo tài liệu dự án, cấu hình đúng địa chỉ Ollama và cơ chế đăng nhập. Kiểm license của giao diện riêng; nó không tự mang license MIT chỉ vì kết nối Ollama.
Kết nối Ollama với ứng dụng, AI agent và VPS
Ứng dụng khác có thể gọi server qua REST hoặc các phần OpenAI-compatible được hỗ trợ. Đổi base URL là bước đầu, vẫn cần kiểm model ID, schema tool, streaming và tham số.
from openai import OpenAI
client = OpenAI(base_url="http://localhost:11434/v1", api_key="ollama")  # api_key bắt buộc nhưng Ollama không kiểm
r = client.chat.completions.create(model="gemma4", messages=[{"role": "user", "content": "Xin chào"}])
print(r.choices[0].message.content)
OpenAI compatibility mô tả endpoint và giới hạn cụ thể. Một số hướng tích hợp:
- Workflow: n 8 n có tích hợp Ollama hoặc có thể gọi HTTP theo tài liệu.
- Agent: Hermes/OpenClaw cần cấu hình provider, endpoint và model đúng phiên bản.
- GUI khác: LM Studio là một lựa chọn runtime/giao diện riêng; xem bảng công cụ local.
Trên Linux, tài liệu có script cài và dịch vụ nền. Đọc script từ nguồn chính thức trước khi thực thi, kiểm quyền và vị trí dữ liệu. Nếu agent cùng máy, giữ loopback; server CPU cần chọn model và context có đo latency thực tế.
Kết luận
Ollama giúp bắt đầu chạy model và mở API thuận tiện. Chọn đúng checkpoint, phân biệt local/cloud, kiểm tài nguyên và bảo vệ endpoint là những việc cần làm trước khi nối vào công việc tự động.
Câu hỏi thường gặp
Ollama AI có miễn phí không?
Phần mềm theo MIT và inference local không có phí API token của dịch vụ cloud. Bạn vẫn trả cho thiết bị/điện; checkpoint và sản phẩm cloud có license/billing riêng.
Hai lý do chính để chạy LLM cục bộ với Ollama là gì?
Hai động lực phổ biến là kiểm soát dữ liệu và tận dụng phần cứng ở tải phù hợp. Cả hai cần kiểm toàn bộ hệ thống: công cụ ngoài vẫn có thể gửi dữ liệu, còn chi phí máy mới có thể lớn hơn gọi API.
Tôi cần cấu hình máy tính như thế nào để chạy Ollama AI?
Phụ thuộc tag, quant và context bạn chọn. Kiểm OS/GPU được hỗ trợ, dung lượng đĩa cho model và bộ nhớ/cache trong lúc chạy. Không có một mức RAM duy nhất bảo đảm mọi model hoạt động tốt.
Tôi có thể sử dụng Ollama AI ngoại tuyến không?
Inference với checkpoint đã có và ứng dụng không gọi dịch vụ ngoài có thể chạy offline. Download, cập nhật, cloud model và tool tra cứu vẫn cần mạng.
Open WebUI mang lại lợi ích gì khi sử dụng với Ollama?
Nó cung cấp giao diện hội thoại và quản lý người dùng/kết nối theo tính năng ứng dụng. Tốc độ suy luận và nhu cầu RAM/VRAM vẫn do model, runtime và máy quyết định.
Ollama AI có phù hợp cho doanh nghiệp không?
Có thể phù hợp nếu model và tải đáp ứng yêu cầu, tổ chức kiểm license, dữ liệu và bảo mật. Với nhiều người dùng, cần đo throughput, phân quyền và quan sát; không mở API local trực tiếp ra Internet.