Local model là gì? Chạy AI trên máy riêng và dùng với agent
Từ trọng số, inference runtime tới RAM/VRAM, quyền riêng tư và cách chọn giữa local với API hosted.
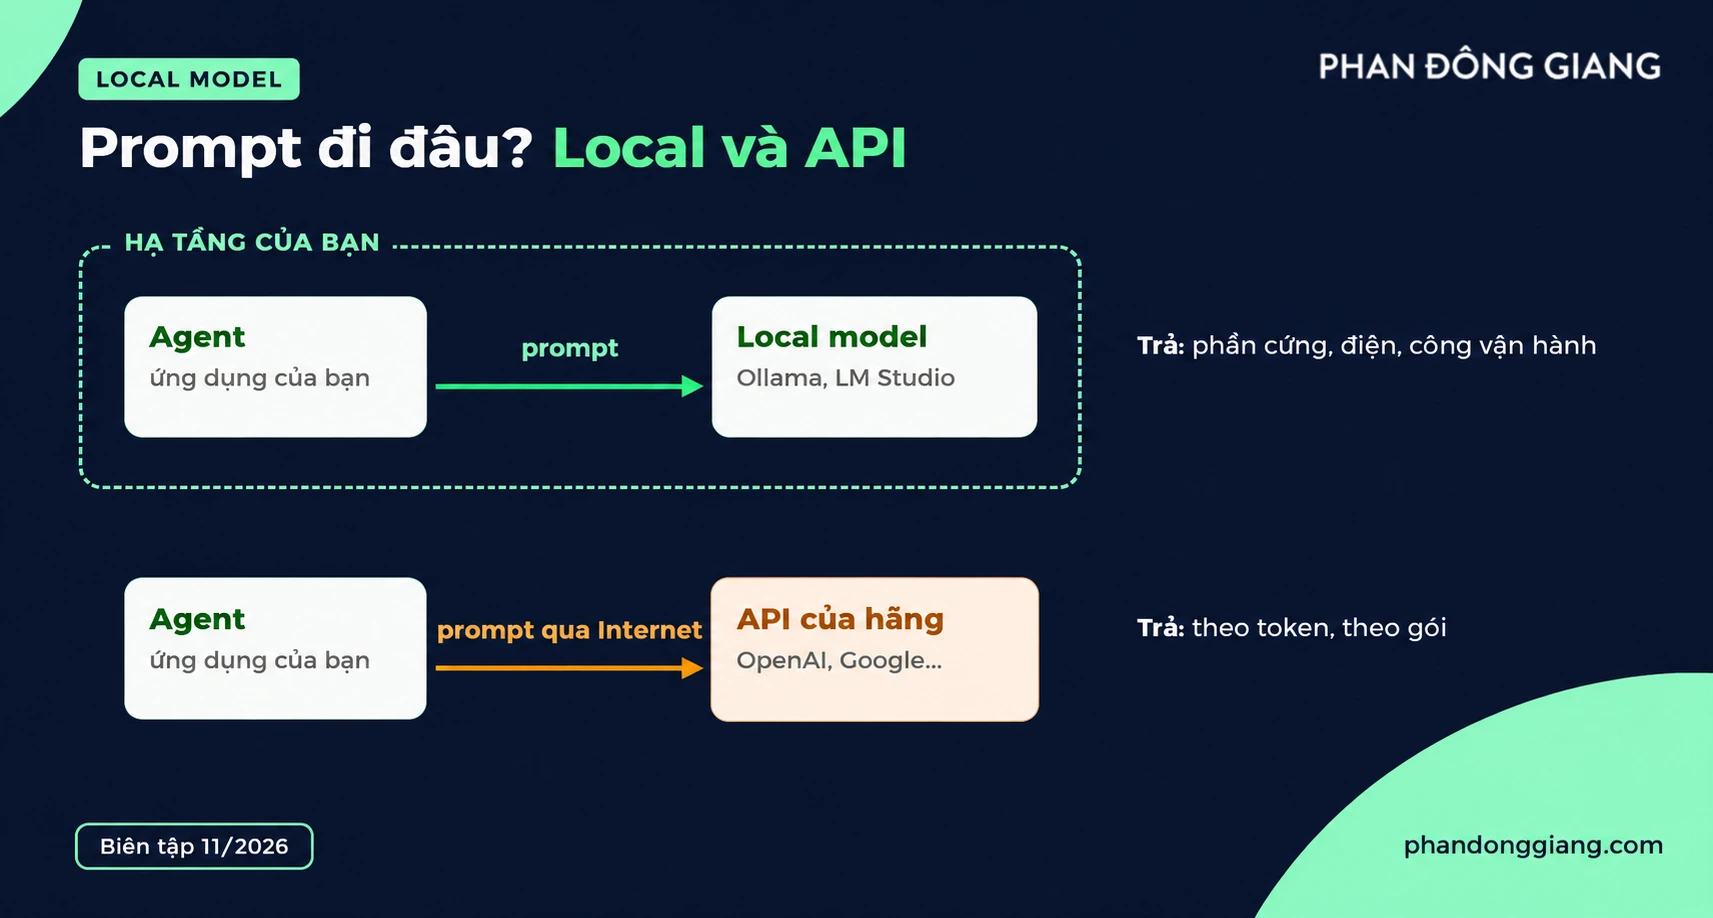
Local model là mô hình được suy luận trên thiết bị hoặc hạ tầng bạn quản lý, thay vì gửi phần suy luận chính tới endpoint hosted của nhà cung cấp. Hạ tầng đó có thể là máy cá nhân, máy trạm hoặc server nội bộ. Quyền kiểm soát tăng lên, đồng thời bạn chịu trách nhiệm về phần cứng, phần mềm và vận hành.
Đây là điểm bắt đầu cho cụm chạy AI local: chọn runtime, tải trọng số và nối model với ứng dụng/agent. Nếu định dùng dịch vụ hosted, xem API LLM miễn phí và dùng thử; hai cách triển khai có chi phí và ranh giới dữ liệu khác nhau.
Đối chiếu Ollama, LM Studio và vLLM. Runtime, GPU backend và license thay đổi độc lập với checkpoint model, nên kiểm lại cả hai trước khi cài.
Đôi nét về local model
Cần tách hai phần: trọng số là dữ liệu tham số model; inference runtime là phần mềm nạp trọng số và tính đầu ra. Ứng dụng chat hay agent ở bên ngoài gửi request tới runtime đó.
Local model là gì?
“Local” nói về nơi xử lý, không phải tên một model hay giấy phép. Một server ở trung tâm dữ liệu vẫn có thể là triển khai riêng của bạn; ngược lại, ứng dụng cài trên laptop nhưng gọi cloud model không phải inference hoàn toàn cục bộ.
Bạn có thể dùng Ollama, LM Studio, llama.cpp hoặc vLLM; tải checkpoint từ Hugging Face hoặc nguồn được phép. Ứng dụng sau đó gọi endpoint riêng, thường như localhost:11434 với Ollama hoặc localhost:1234/v 1 với LM Studio.
Agent đòi hỏi hơn một lượt chat: model cần đọc kết quả tool, chọn bước tiếp và giữ đúng mục tiêu qua nhiều vòng. Khả năng runtime hiểu schema tool và trả lời đúng định dạng quan trọng không kém một câu trả lời chat hay.
Hãy thử agent bằng tác vụ có thể kiểm chứng như đọc file mẫu hoặc gọi tool giả. Chat trôi chảy không đủ chứng minh model tuân thủ quyền, dùng đúng tool hay duy trì ngữ cảnh trong workflow dài.
Local model khác dùng model qua API thế nào?
Local chuyển phần chi phí sang thiết bị, điện, bảo trì và quản trị. Hosted API chuyển phần inference sang nhà cung cấp với billing và chính sách riêng. So sánh theo tổng chi phí cho nhiệm vụ hoàn tất, không chỉ giá mỗi token.
| Tiêu chí | Local model | Model qua API |
|---|---|---|
| Dữ liệu prompt | Ở lại máy hoặc máy chủ của bạn | Gửi tới máy chủ của hãng, theo chính sách dữ liệu của hãng |
| Chi phí | Phần cứng, điện, thời gian cài đặt | Theo token hoặc gói; có thể có hạn mức miễn phí |
| Chất lượng | Tuỳ model mở bạn chạy được trên phần cứng hiện có | Dùng được các model thương mại mới của hãng |
| Cập nhật model | Tự tải bản mới | Hãng cập nhật, nhưng cũng có thể ngừng model cũ |
| Cần mạng | Không, sau khi đã tải model | Có |
Tại sao nhiều người muốn dùng local model cho AI Agent?
Ba động lực thường gặp là dữ liệu, lượng sử dụng và tùy chỉnh. Mỗi động lực cần được kiểm bằng thiết kế cụ thể thay vì chỉ dựa vào nhãn local.
- Kiểm soát dữ liệu: giữ inference trong môi trường riêng, đồng thời rà tool, telemetry và dịch vụ ngoài có thể gửi dữ liệu.
- Tải lặp lại: tận dụng phần cứng khi workflow chạy nhiều; lợi ích phụ thuộc mức sử dụng, chất lượng model và chi phí vận hành.
- Tùy chỉnh: chọn checkpoint, quant, context và backend; có thể tối ưu cho tác vụ riêng hoặc kết hợp nhiều model.
Không mất phí API không có nghĩa không mất chi phí. Xem đánh đổi của model miễn phí để tính cả điện, thời gian cấu hình và lỗi cần sửa.
Các framework như Hermes và OpenClaw có thể nối runtime được hỗ trợ hoặc endpoint tương thích. Cần kiểm cả API dialect, model ID, tool parser và cấu hình của phiên bản agent.
Ưu – nhược điểm khi dùng local model cho AI Agent
Local hữu ích khi kiểm soát hạ tầng là ưu tiên. Thách thức lớn thường là bộ nhớ, tốc độ, độ tin cậy của tool calling và khả năng giám sát; không có một cấu hình tối ưu cho tất cả agent.
Ưu điểm
- Ranh giới dữ liệu rõ hơn: có thể giới hạn inference trong mạng riêng.
- Tận dụng tài nguyên: phần cứng sẵn có có thể giảm chi phí biến đổi ở tải phù hợp.
- Giữ checkpoint: tránh phụ thuộc trực tiếp vào lịch ngừng endpoint hosted.
- Linh hoạt: phối hợp model nhỏ, model code hoặc cloud fallback khi có lý do.
- Nối ứng dụng riêng: dùng endpoint nội bộ với auth và phân quyền phù hợp.
Nhược điểm
- Giới hạn phần cứng: thiếu RAM/VRAM thường gây chậm, offload hoặc không nạp được; nó không tự làm model thông minh kém đi nếu phép tính vẫn đúng.
- Context tốn bộ nhớ: KV cache và concurrency có thể làm vượt bộ nhớ dù file trọng số vừa.
- Tool calling không đồng đều: cần đúng template/parser và model được huấn luyện cho công cụ.
- Latency thay đổi: phụ thuộc GPU/CPU, quant, prompt dài và số người dùng.
- Công sức vận hành: cập nhật runtime, model và xử lý lỗi thuộc trách nhiệm của bạn.
- Rủi ro agent: prompt injection và tool quá quyền vẫn tồn tại trong mạng riêng; cần sandbox và kiểm soát truy cập.
Khi nào nên dùng và không nên dùng local model cho AI Agent?
Local đáng thử khi dữ liệu, phần cứng và đội vận hành phù hợp. Hosted thường thuận tiện khi cần triển khai nhanh hoặc dùng model không có trọng số. Quyết định nên dựa trên thử nghiệm có tiêu chí chứ không mặc định bên nào luôn tốt hơn.
Khi nào NÊN dùng local model cho AI Agent?
- Xử lý tài liệu nội bộ với chính sách không gửi dữ liệu ra hosted API.
- Đã có tài nguyên đủ cho checkpoint và tải dự kiến.
- Workflow lặp nhiều để chi phí đầu tư được khai thác.
- Muốn kiểm soát runtime, trạng thái và môi trường tool.
- Có thời gian benchmark và tối ưu trước khi vận hành thật.
Khi nào KHÔNG NÊN dùng local model?
- Không có bộ nhớ đủ hoặc latency thử nghiệm không đạt yêu cầu.
- Cần triển khai ngay nhưng chưa có năng lực vận hành runtime.
- Tác vụ cần model hosted cụ thể không thể tự chạy.
- Chưa có phân quyền, log và cách chặn hành động ngoài phạm vi của agent.
Nên chọn local model như thế nào?
Xuất phát từ tác vụ rồi chọn model và máy, thay vì tải model lớn nhất có thể. Đo chất lượng, context thực dụng, tool calling, latency và tổng tài nguyên trên cùng một tập bài thử.
Tiêu chí lựa chọn local model cho AI Agent
Một bộ tiêu chí hữu ích cho agent gồm:
- Context phù hợp: đủ cho prompt, lịch sử tool và phần dữ liệu liên quan, không chỉ trần quảng cáo.
- Tool chính xác: tên hàm, tham số và trạng thái sau tool đều đúng.
- Bám yêu cầu: không mở rộng hành động ngoài phạm vi.
- Code/terminal khi cần: kết quả phải qua test và kiểm tra thay đổi.
- Tài nguyên hợp máy: chọn quant và concurrency có đo bộ nhớ/throughput.
Đọc license của checkpoint và bản quant bên cạnh runtime. Open-weight có thể dùng license riêng; quyền thương mại không suy ra chỉ từ nút tải. Xem LLM mở và cách đọc Hub.
Phân loại model theo nhu cầu thực tế
- Code: thử checkpoint chuyên code cùng repository/test đại diện.
- Tool: ưu tiên phép thử function calling thực tế hơn điểm chat chung.
- Reasoning: dùng khi cần lập kế hoạch; cân bằng độ trễ và số vòng tự sửa.
- Học và thử nhẹ: bắt đầu checkpoint nhỏ để hiểu luồng nạp model, không vội giao quyền agent rộng.
Các công cụ chạy local model phổ biến
Ollama đơn giản hóa quản lý model; LM Studio cung cấp GUI và runtime/server; vLLM hướng tới phục vụ tải có yêu cầu hệ thống. API compatibility chỉ là một phần giao thức, không bảo đảm thay backend mà không kiểm thử.
Ollama: dễ bắt đầu bằng dòng lệnh
Ollama có CLI và server cho model local; bản release mới nhất là v 0.40.16. Nó cũng cung cấp cloud model, nên cần phân biệt model đang thực thi trên máy với model hosted. Phần OpenAI-compatible là một tập tính năng được tài liệu mô tả.
Concurrency và context làm tăng tài nguyên. Rà OLLAMA_NUM_PARALLEL, scheduling và bộ nhớ theo FAQ; không áp một giá trị mặc định cho mọi release/model mà không đọc cấu hình hiện tại.
Hướng dẫn chi tiết: Ollama.
LM Studio: giao diện đồ hoạ
LM Studio cho tìm model, chat và bật API; changelog hiện liệt kê 0.4.28. Có llmster cho headless và tích hợp agent theo docs. Các sản phẩm như Bionic có version riêng, không dùng số bản của chúng thay số bản LM Studio.
Thực hành tại LM Studio.
VLLM: phục vụ nhiều người dùng
VLLM có cơ chế phục vụ nhiều request và hỗ trợ nhiều loại accelerator theo bản build. Kiểm kiến trúc model, backend và recipe chính thức; đây không phải cách cài GUI một nút và không tự tối ưu mọi tải.
Đọc so sánh công cụ chạy local để xem thêm Jan, GPT 4 All và llama.cpp.
Chạy local model trên máy tính hay trên VPS?
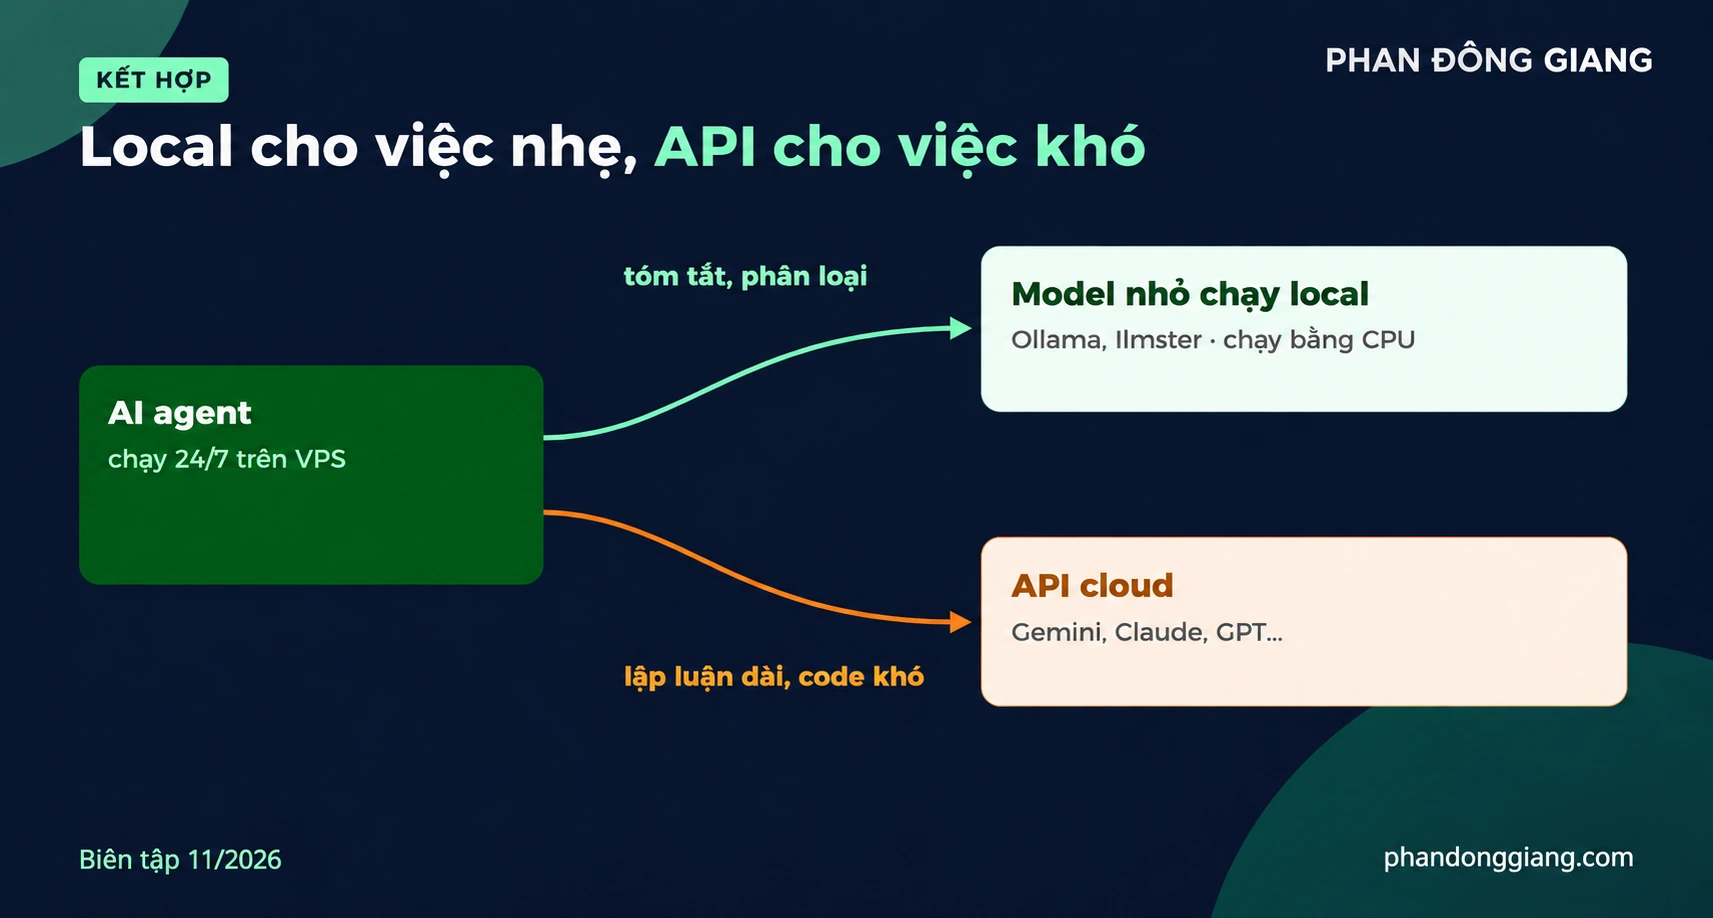
Máy có GPU hoặc unified memory đủ lớn thích hợp thử inference. Server CPU có thể chạy model phù hợp nhưng phải đo tốc độ; một VPS chỉ chạy agent rồi gọi API không biến cloud model thành local.
- Máy cá nhân: dễ thử và kiểm dữ liệu, nhưng uptime phụ thuộc máy đang bật.
- Server riêng: có thể chạy liên tục, cần đủ tài nguyên và bảo trì.
- Mạng: ưu tiên loopback hoặc mạng riêng; nếu mở endpoint cho máy khác, dùng auth, firewall và giới hạn truy cập, không phơi cổng 11434/1234 công khai.
Khi chuyển agent sang server, tách tài khoản hệ thống, bí mật và quyền tool; tính cả backup và phục hồi. Chỉ chuyển nơi chạy agent chưa chứng minh nơi model suy luận đã thay đổi.
Kết luận
Local là lựa chọn triển khai có lợi ích rõ khi yêu cầu dữ liệu và tải phù hợp, nhưng không có đáp án chung về giá/chất lượng. Hãy đo trên phần cứng thật trước khi đầu tư.
Cấu hình hybrid có thể dùng local cho bước phù hợp và cloud cho việc khác, với quy tắc dữ liệu rõ ràng. Không gửi tác vụ nhạy cảm lên fallback chỉ vì model local báo lỗi.
Mục lục cụm chạy model local
Các bài sau đi từ chọn runtime, tải checkpoint tới đánh giá và vận hành. Chọn phần bạn cần, rồi quay lại đối chiếu tổng thể về dữ liệu, chi phí và chất lượng.
- LM Studio là gì? Cách cài và dùng LM Studio chạy AI local
- Ollama là gì? Cách cài Ollama và chạy model bằng dòng lệnh
- Hugging Face là gì? Kho model, dataset và Spaces
- Các công cụ chạy local model: so sánh theo tiêu chí
- Các mô hình LLM open source và giấy phép
- Ưu nhược điểm khi dùng model AI miễn phí cho AI agent
Câu hỏi thường gặp
Máy tính không có GPU có chạy được model local với Hermes Agent không?
CPU có thể suy luận nếu runtime và model hỗ trợ, nhưng agent nhiều vòng thường có độ trễ lớn hơn. Thử checkpoint nhỏ/quant phù hợp và đo latency; không quyết định chỉ theo việc tải được file.
Model Hermes 3 và Hermes Agent có phải là cùng một thứ không?
Không. Một họ model có thể mang tên Hermes, còn Hermes Agent là phần mềm điều phối model và công cụ. Agent có thể dùng model của nhiều hãng; model Hermes cũng có thể chạy trong phần mềm khác.
OpenClaw có hỗ trợ model local không cần Ollama không?
Có thể dùng runtime khác nếu phiên bản OpenClaw hỗ trợ provider hoặc API tương thích của nó. Với LM Studio, bật server rồi làm theo integration hiện hành; kiểm endpoint và model ID thay vì chỉ đổi cổng.
Model local có thể tự cập nhật lên phiên bản mới hơn không?
Checkpoint chỉ thay khi phần mềm hoặc bạn tải/cập nhật nó theo cơ chế quản lý đang dùng. Hãy ghim version hoặc digest khi cần tái hiện; kiểm lại chất lượng sau mỗi lần pull thay vì mặc định model mới giữ nguyên hành vi.