LM Studio: tải model, chat tài liệu và mở API local
Hướng dẫn LM Studio 0.4.x, chọn quant phù hợp, dùng server có xác thực và phân biệt Bionic, llmster, lms.
LM Studio là ứng dụng của Element Labs để tìm, tải và chạy model trên máy, với giao diện chat cùng API cho phần mềm khác. Khi checkpoint và toàn bộ luồng xử lý ở local, inference có thể thực hiện trong hạ tầng bạn quản lý. API thường ở localhost:1234; việc dùng cloud hoặc tool ngoài là lựa chọn riêng cần kiểm.
Bài đi từ điều kiện máy, cài đặt tới dùng tài liệu và server. Xem khái niệm local model để phân biệt inference riêng với hosted; nếu chưa cần tự chạy, API LLM là đường thử khác.
Đối chiếu: changelog LM Studio liệt kê 0.4.28, Build 2 sửa cập nhật trên Mac. Đừng nhầm với changelog Bionic hoặc engine llama.cpp có version độc lập. System Requirements là nguồn kiểm máy trước khi tải.
Tổng quan về LM Studio
Thay vì tự làm mọi thao tác qua CLI, bạn có thể tìm checkpoint, chọn quant, nạp vào bộ nhớ rồi chat hoặc mở server. Các ước tính tương thích giúp bắt đầu nhưng vẫn cần đo trên máy thực.
LM Studio là gì?
LM Studio quản lý model và giao diện sử dụng. Câu trả lời đến từ checkpoint đang nạp, không phải một model riêng tên LM Studio; thay checkpoint có thể thay khả năng, license và mức dùng tài nguyên.
Luồng bắt đầu thường là chọn một model phù hợp, tải về rồi mở cuộc chat. GUI giảm thao tác kỹ thuật ban đầu, nhưng không thay bước kiểm nguồn trọng số, dữ liệu và chất lượng đầu ra.
Ứng dụng có chat, tìm model, kết nối công cụ và server. GGUF thường chạy qua llama.cpp; trên Apple Silicon còn có các runtime như MLX theo hỗ trợ hiện hành. API compatibility và modality cần xem đúng engine/model.
Tài liệu hiện hỗ trợ Apple Silicon/macOS 14+, Windowsx 64/ARM và Linuxx 64/ARM 64 theo điều kiện cụ thể. LM Studio desktop có điều khoản ứng dụng riêng, không phải toàn bộ mã nguồn đều theo một license open-source; checkpoint vẫn có license khác.
LM Studio, Bionic, llmster và lms khác nhau thế nào?
LM Studio, Bionic, llmster và lms là các thành phần khác nhau. Số bản và quyền lợi của ứng dụng agent Bionic không tự áp sang LM Studio desktop hoặc runtime headless.
| Sản phẩm | Là gì | Dùng khi |
|---|---|---|
| Ứng dụng LM Studio | Phần mềm có giao diện: tải model, chat, chat với tài liệu, bật local server, MCP | Bạn mới bắt đầu hoặc muốn chỉnh cấu hình model chi tiết |
| LM Studio Bionic | Ứng dụng agent riêng (ra mắt 16/07/2026) làm việc nhiều bước với code, tài liệu, file; chạy bằng model local, model trên máy khác qua LM Link hoặc model mở trên cloud của LM Studio | Bạn muốn một AI agent trên máy; gói Free có agent và model local, gói trả phí thêm model cloud |
| Llmster | Dịch vụ chạy nền (daemon) không cần giao diện, là lõi của LM Studio đóng gói cho máy chủ | Chạy trên VPS, máy chủ Linux, máy GPU không màn hình, CI/CD |
| Lms | Công cụ dòng lệnh: tải model, bật tắt server, quản lý daemon | Điều khiển LM Studio hoặc llmster bằng script |
LM Studio dùng để làm gì?
Bạn có thể dùng để thử model, chat riêng, hỏi tài liệu hoặc cung cấp endpoint cho ứng dụng. Trước khi chọn, xác định ai gọi model, dữ liệu đi đâu và máy cần xử lý bao nhiêu request.
- Cá nhân: thử model và lưu hội thoại trong môi trường mình quản lý.
- Developer: tích hợp endpoint local vào ứng dụng có kiểm thử.
- Nghiên cứu: so checkpoint và cấu hình trên cùng bộ dữ liệu.
- Tổ chức: triển khai riêng với phân quyền, backup và chính sách dữ liệu phù hợp.
Ưu điểm nổi bật của LM Studio
GUI là lợi thế rõ khi bắt đầu, còn SDK/CLI/API giúp tích hợp sâu hơn. Tính tiện dụng không phải lời bảo đảm mọi model, MCP hoặc hệ thống agent đều tương thích.
- Tìm và nạp model bằng GUI: giảm số bước CLI ban đầu.
- Inference riêng: hỗ trợ kiểm soát dữ liệu khi không sử dụng dịch vụ ngoài.
- Đa dạng checkpoint: chọn từ nguồn được hỗ trợ, với yêu cầu máy và license riêng.
- API server: cho script hoặc ứng dụng gọi model qua các endpoint được triển khai.
- Thử agent: kết nối công cụ theo quyền, dùng log và phép thử để kiểm tool calling.
Vì sao LM Studio phù hợp với xu hướng AI Agent?
Trong kiến trúc agent, LM Studio có thể là nơi cung cấp inference, còn agent điều phối mục tiêu, memory và tool. Chất lượng một vòng agent phụ thuộc cả model lẫn chương trình thực hiện công cụ.
Integration docs có hướng dẫn cho nhiều agent và công cụ. Endpoint OpenAI/Anthropic-compatible, SDK và CLI là những bề mặt khác nhau; dùng recipe đúng phiên bản thay vì giả định chỉ đổi base URL là đủ.
MCP mở thêm quyền truy cập tài nguyên và hành động cho model. Chỉ kết nối server được kiểm soát; xem phạm vi đọc file, chạy code và network trước khi bật. Một MCP chạy cùng máy vẫn có thể gửi dữ liệu ra ngoài.
Hướng dẫn cài đặt và sử dụng LM Studio
Quy trình bên dưới gồm kiểm máy, cài app, tải model và chạy thử. Ảnh minh họa giao diện cũ; vị trí nút có thể khác 0.4.28 nên ưu tiên tên chức năng và tài liệu hiện hành.
Yêu cầu hệ thống để chạy LM Studio
Kiểm hệ điều hành, kiến trúc CPU, bộ nhớ và GPU trước khi tải checkpoint lớn.
Mac
Theo docs, macOS cần Apple Silicon và macOS 14 trở lên, khuyến nghị 16 GB RAM. MacIntel không thuộc cấu hình được hỗ trợ hiện tại. Máy 8 GB chỉ nên thử model nhỏ/context khiêm tốn sau khi xem ước tính bộ nhớ.
Windows và Linux
Windows có bản x 64 và ARM; x 64 cần AVX 2. Tài liệu khuyến nghị ít nhất 16 GB RAM và 4 GB VRAM riêng, nhưng đây không phải mức đủ cho mọi model hoặc context.
Linux có bản x 64/ARM 64; System Requirements mô tả AppImage và điều kiện Ubuntu. Changelog mới còn nhắc gói.deb; chọn định dạng thật sự được trang tải cung cấp cho OS của bạn. Headless dùng llmster thay vì ép chạy GUI.
Các bước cài đặt LM Studio
Bước 1: Tải LM Studio
Mở Download, kiểm đúng OS/kiến trúc và tải bộ cài từ nhà phát triển.
Bước 2: Cài đặt LM Studio
- Windows: chạy bộ cài đúng kiến trúc và làm theo hướng dẫn.
- macOS: cài ứng dụng từ file được cung cấp và mở theo cơ chế của hệ điều hành.
- Linux: chọn gói được hỗ trợ, kiểm quyền thực thi/cài đặt theo tài liệu.
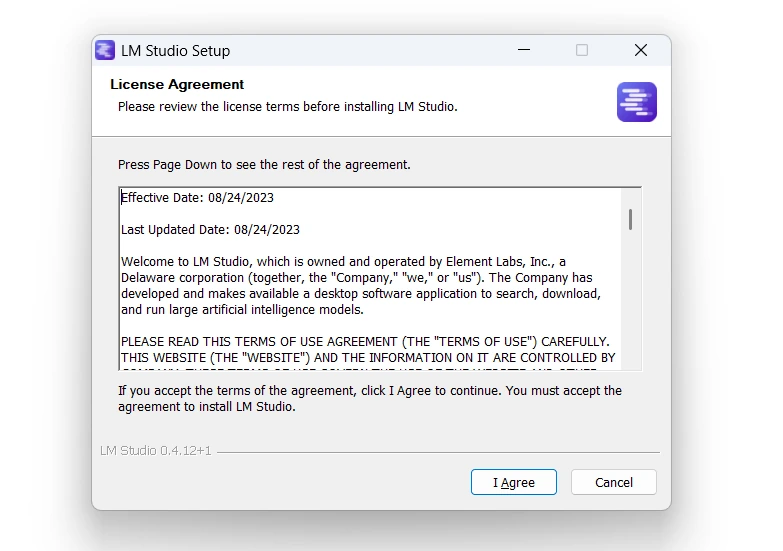
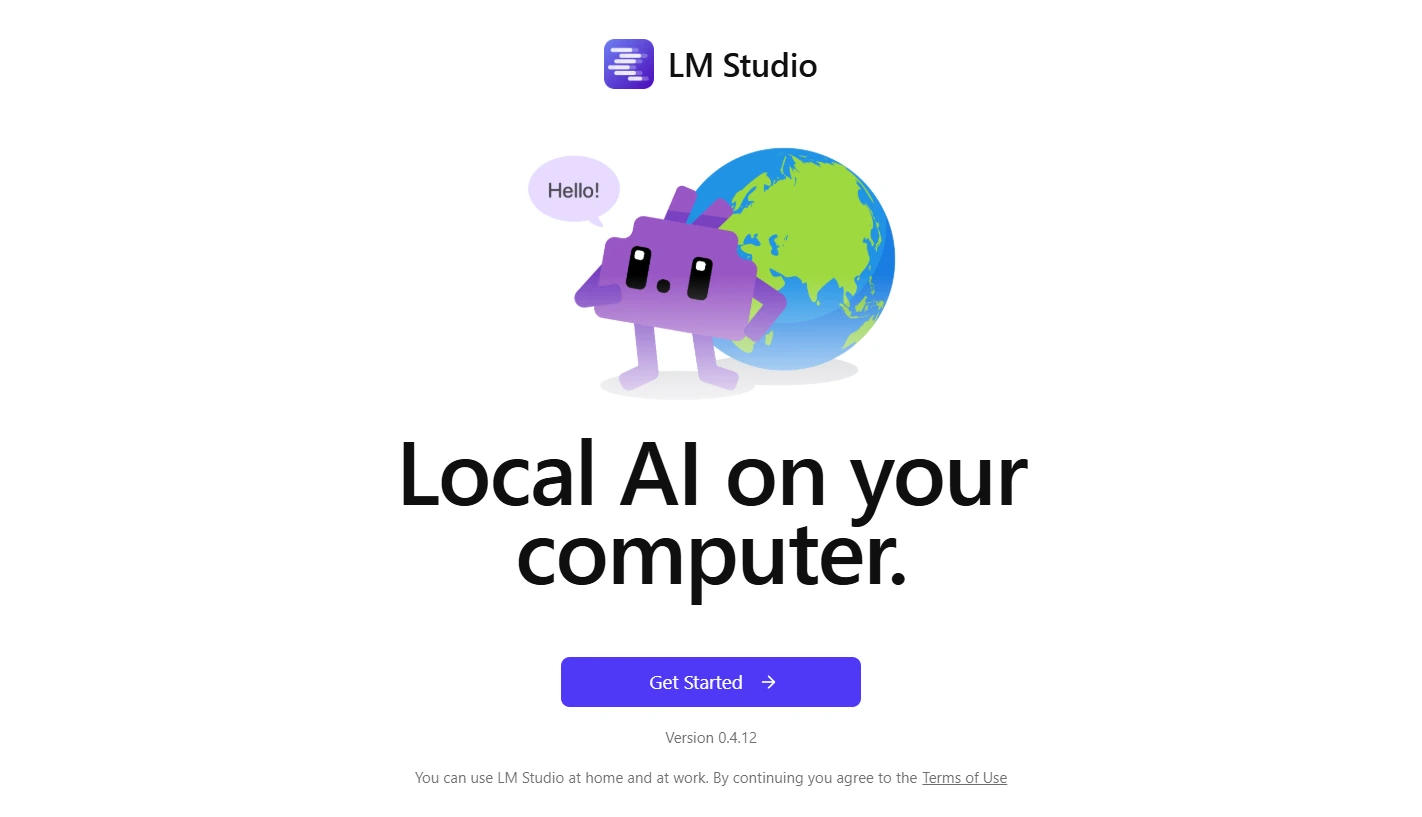
Chọn Get Started hoặc thao tác bắt đầu tương ứng. Màn hình trong ảnh chỉ minh họa giao diện cũ, không xác nhận phiên bản bạn vừa cài.
Bước 3: Khởi động lần đầu
Bạn có thể nhận gợi ý tải model đầu tiên hoặc bỏ qua để tự chọn. Ưu tiên một checkpoint vừa máy và có nguồn rõ thay vì tải theo gợi ý mà chưa kiểm.
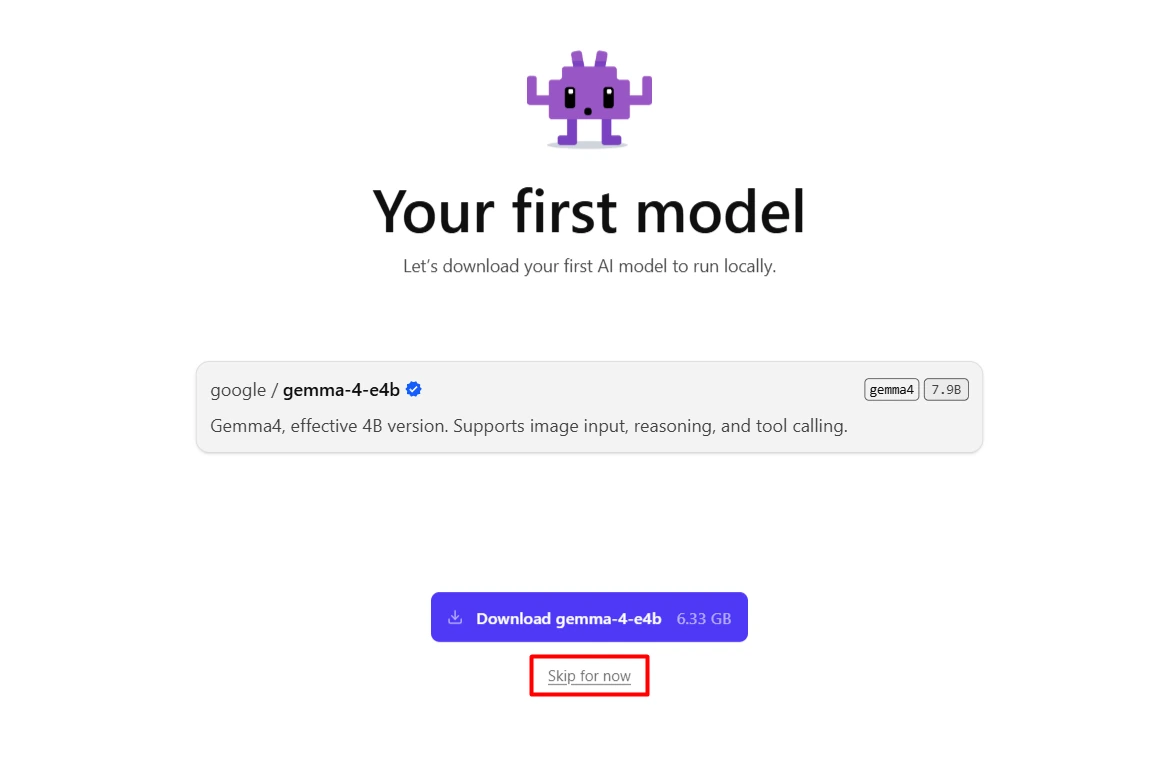
Nếu có lựa chọn khởi động local LLM service khi đăng nhập, bật khi cần server chạy nền; tắt nếu chỉ thử chat. Sau đó tiếp tục vào ứng dụng và kiểm server đang lắng nghe ở đâu.
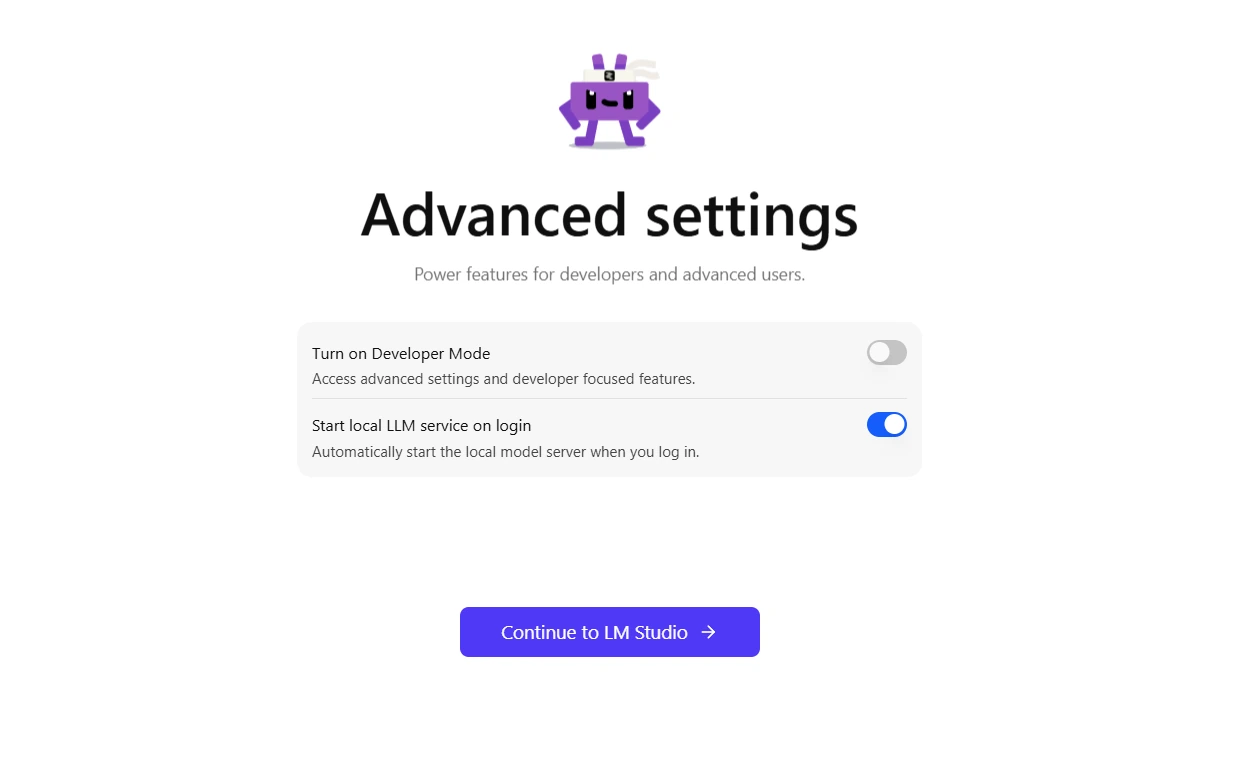
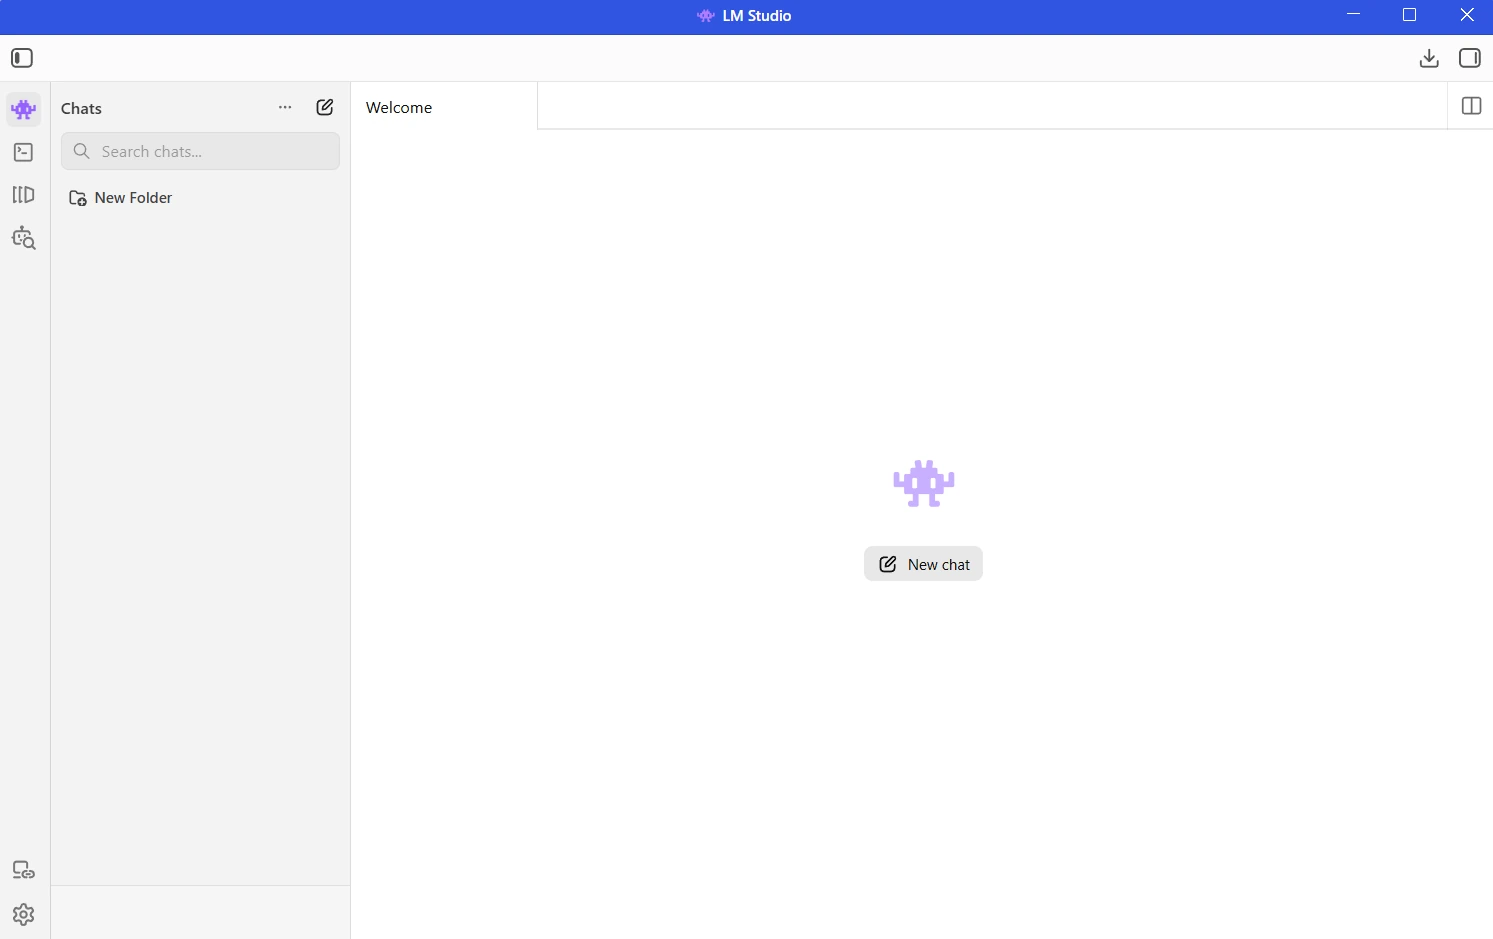
Trong màn hình chính, tìm các khu vực chat, model và developer tương ứng:
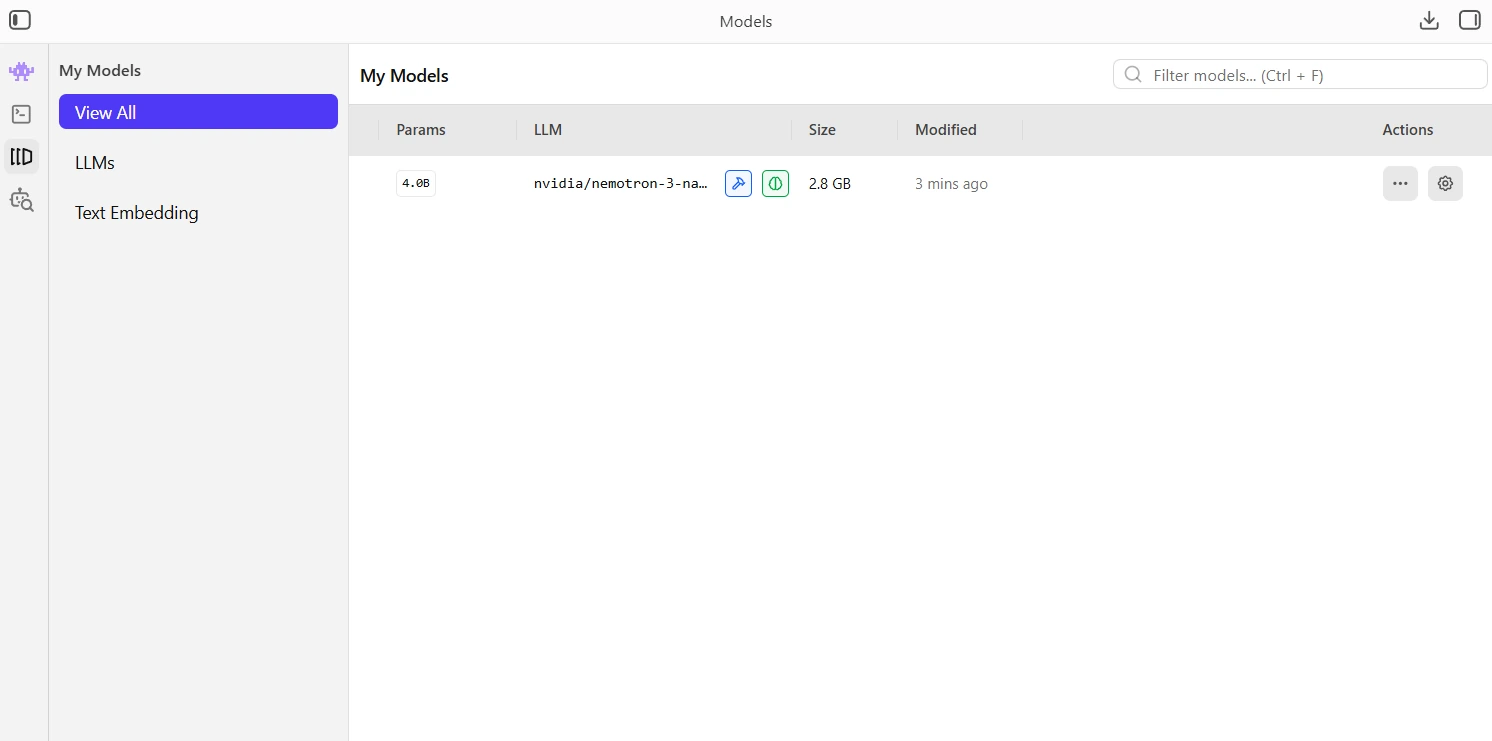
My Models hoặc mục quản lý model cho biết các checkpoint đã có trên đĩa:
Mục tìm kiếm/discover cho tải thêm model. Phân biệt dung lượng file và bộ nhớ cần khi nạp với context cụ thể.
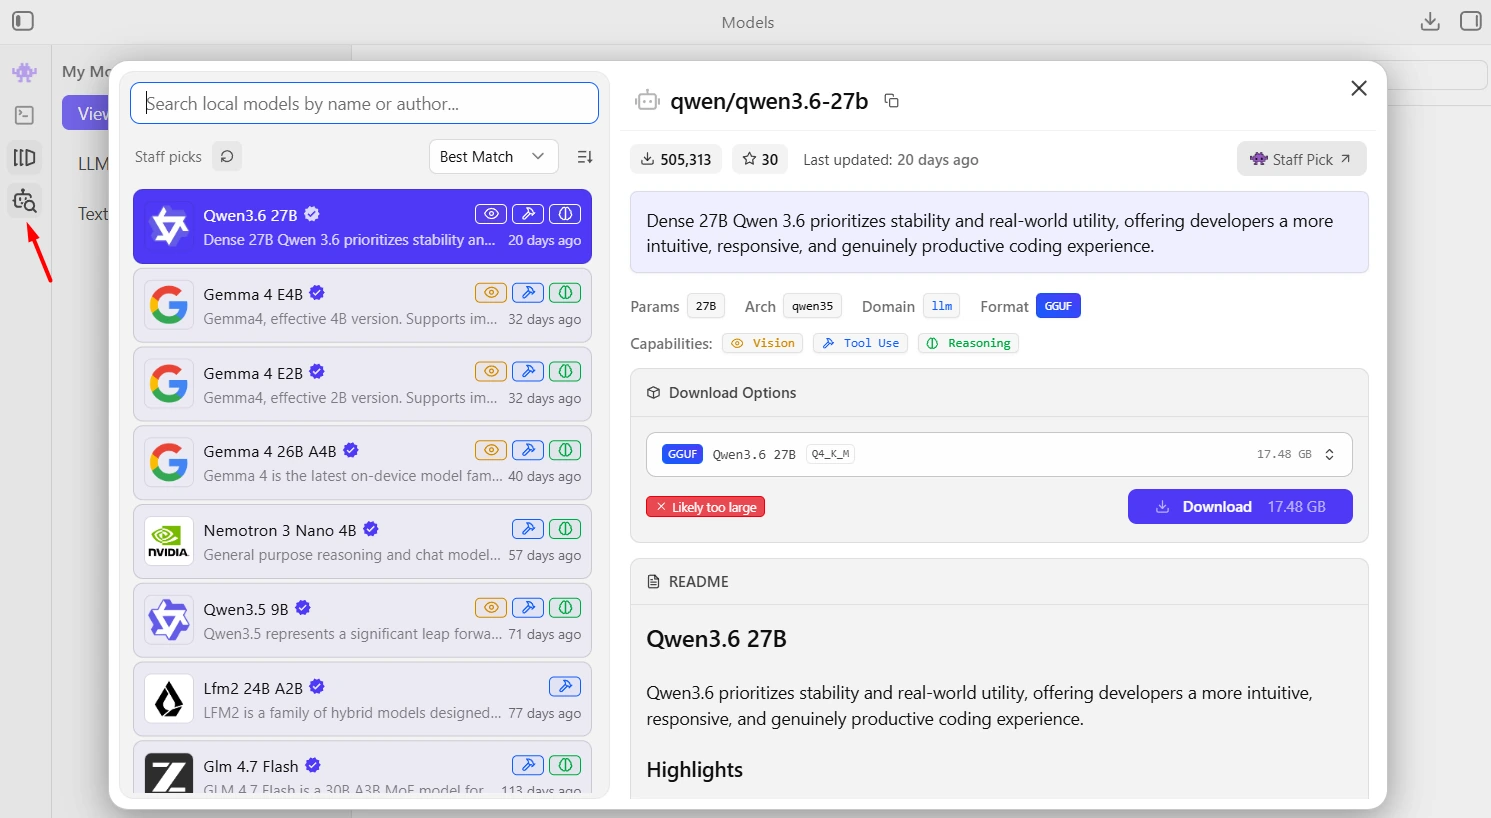
Bước 4: Tải mô hình AI
Tìm kiếm có thể lấy model từ HuggingFace và các nguồn tích hợp. Điều này không miễn trừ việc đọc model card, nguồn quant và license.
Mở Model Search/Discover hoặc biểu tượng tìm kiếm model tương ứng.
- Nhập tên checkpoint hoặc repo chính xác.
- Chọn định dạng/quant mà runtime hỗ trợ và xem ước tính tương thích.
- Tải về, kiểm đủ file rồi mới nạp để thử.
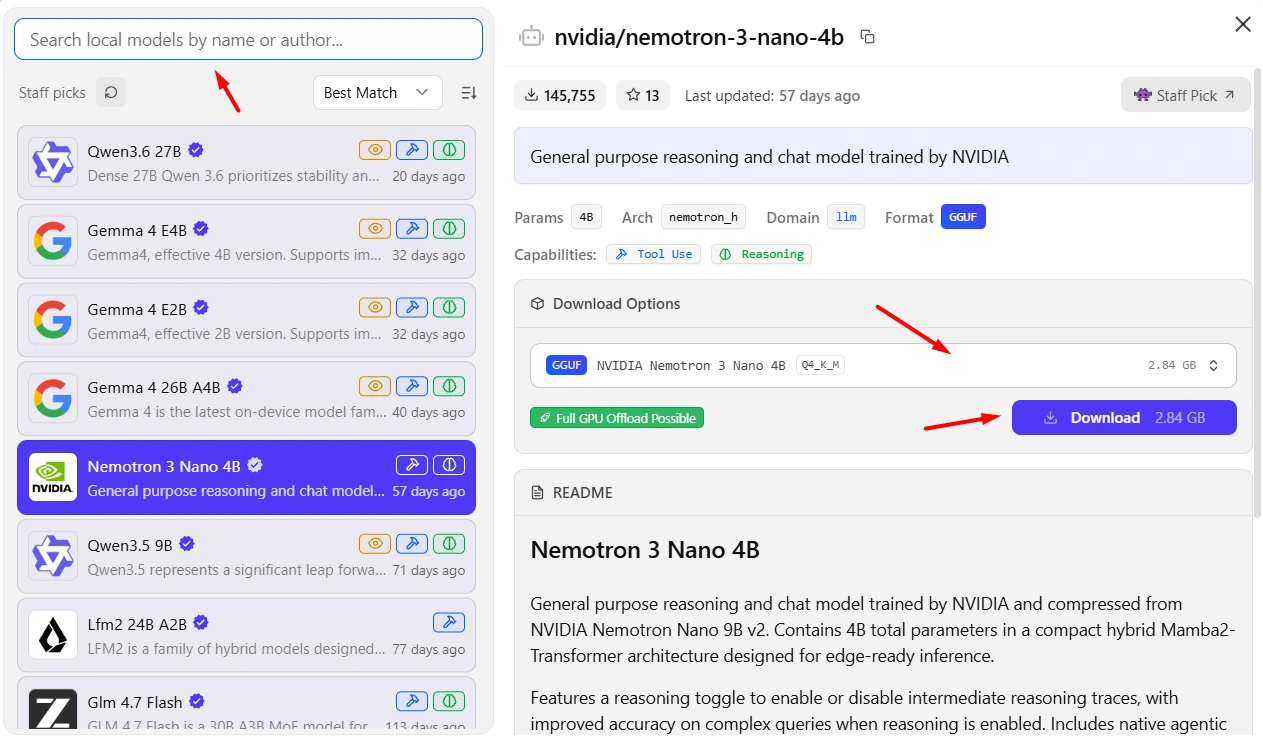
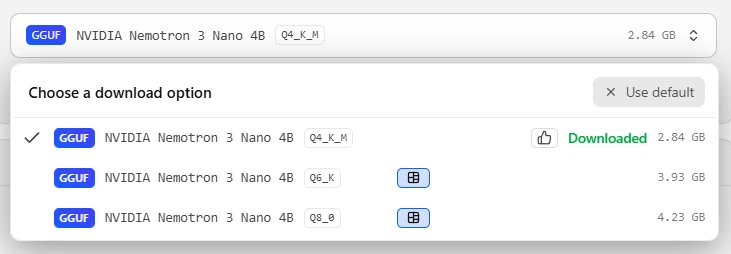
Hiểu quantization trước khi chọn file:
Quantization dùng ít bit hơn để biểu diễn trọng số hoặc thành phần tính toán, thường giảm file/bộ nhớ với mức đánh đổi chất lượng khác nhau. Q4_K_M, Q6_K và Q8_0 không đơn giản là “càng cao càng luôn tốt”: cần so chất lượng, tốc độ và phần cứng với cùng checkpoint.
Hướng dẫn sử dụng các tính năng chính
Năm nhóm thao tác thường dùng là chat, tài liệu, API server, GPU offload và kết nối từ máy khác. Không phải model hoặc engine nào cũng hỗ trợ toàn bộ tính năng giống nhau.
Tính Năng 1: Chat với AI
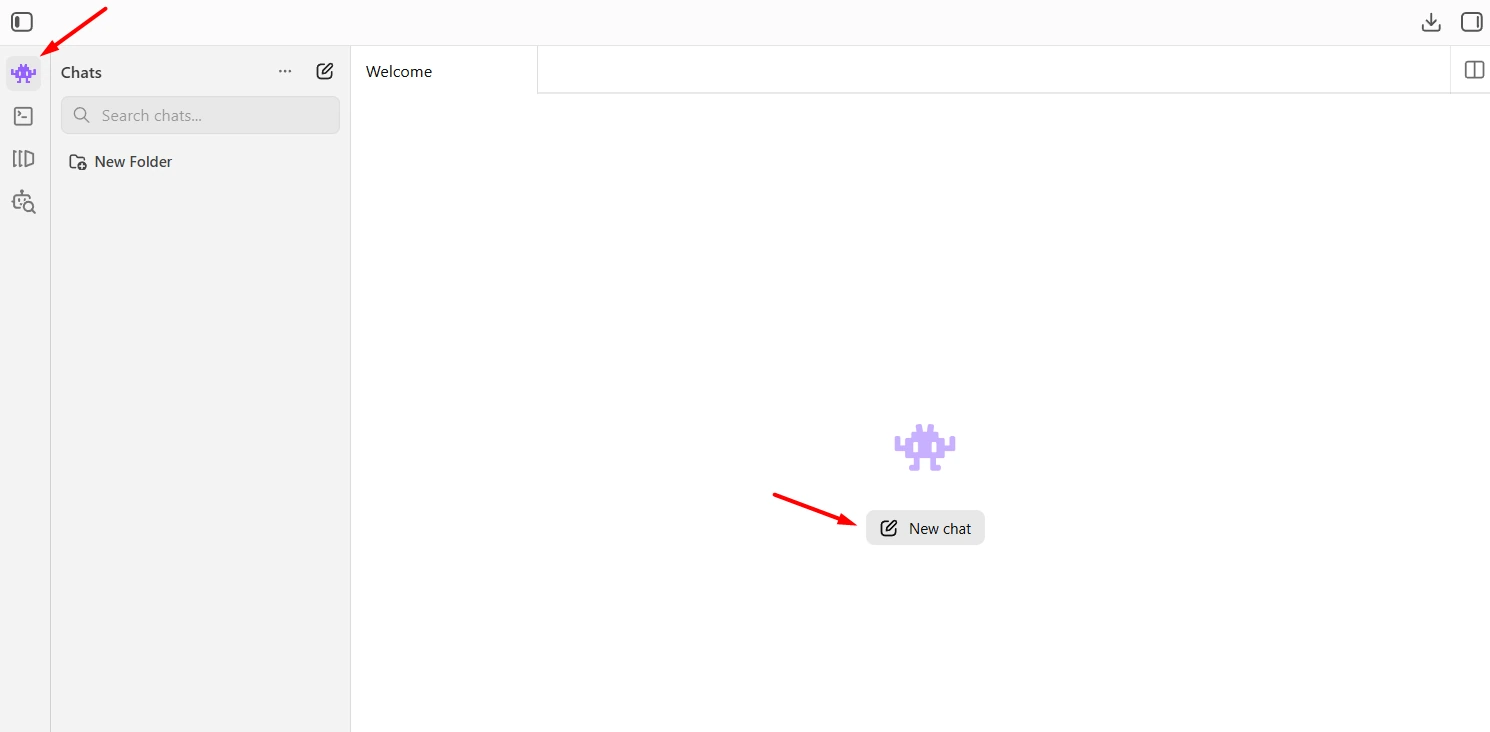
Chọn Use in new chat nếu giao diện có nút này để mở hội thoại với checkpoint vừa tải.
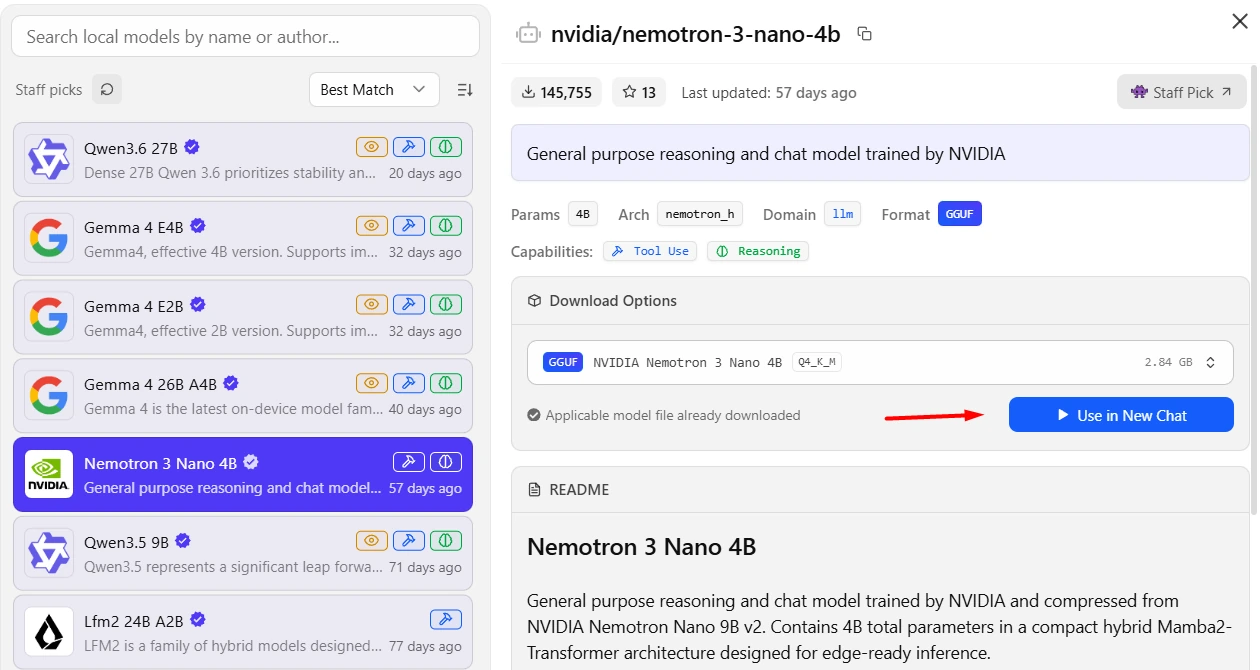
Hoặc mở Chat và tạo cuộc hội thoại mới.
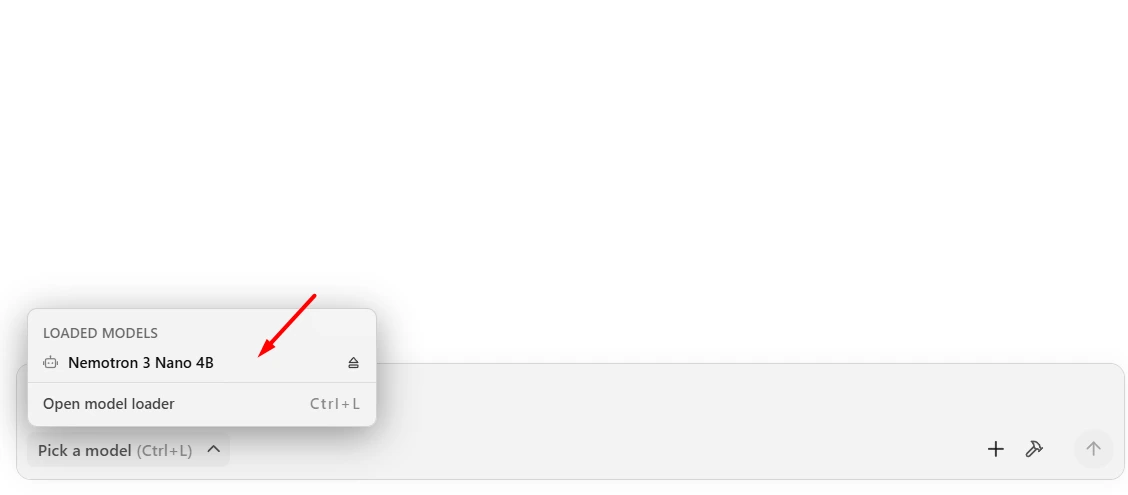
Chọn checkpoint, kiểm context/bộ nhớ và các tùy chọn load rồi nạp model.
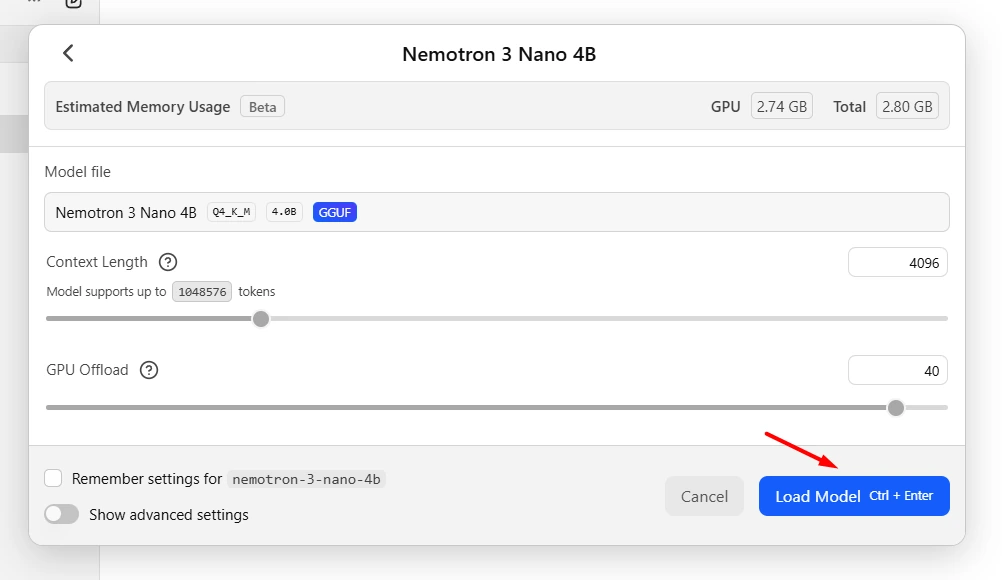
Đợi trạng thái nạp hoàn tất. Model lớn hoặc offload qua CPU có thể lâu; nếu lỗi, đọc thông báo thay vì tiếp tục tải thêm model.
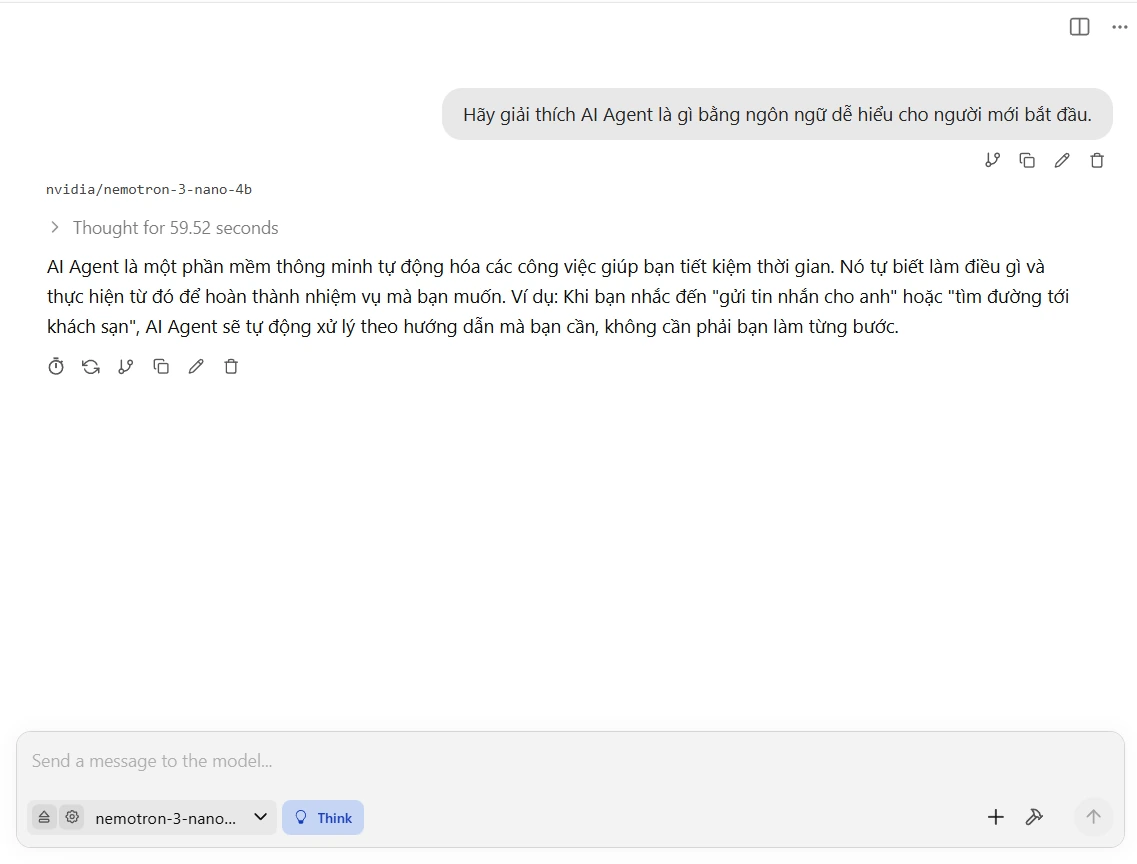
Gửi câu hỏi nhỏ để thử tốc độ, ngôn ngữ và chất lượng. Ví dụ:
Giải thích AI agent cho người mới, kèm một ví dụ và một giới hạn cần nhớ.
System prompt có thể đặt mục tiêu và cách trình bày, ví dụ yêu cầu tiếng Việt dễ hiểu. Nó không thay đổi trọng số và không bảo đảm model luôn tuân thủ hay không bịa.
Tính năng 2: Chat với tài liệu
Tài liệu ngắn có thể nằm trực tiếp trong context; tài liệu dài thường cần retrieval để chọn đoạn liên quan. Kiểm Chat with Documents theo version hiện hành và luôn kiểm nội dung được trích.
Trong chat, chọn thao tác đính kèm tài liệu.
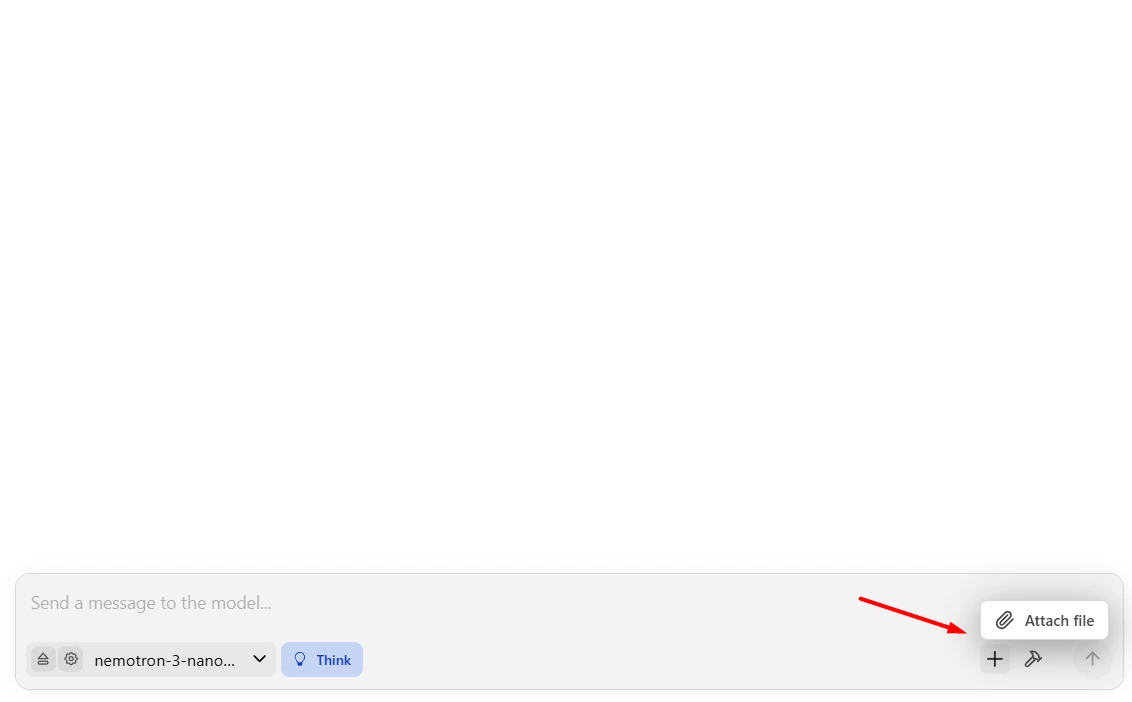
Tải định dạng được ứng dụng hỗ trợ rồi hỏi một câu cụ thể về nội dung. Nếu file scan, cần xem phần trích xuất/OCR có đọc đúng hay không.
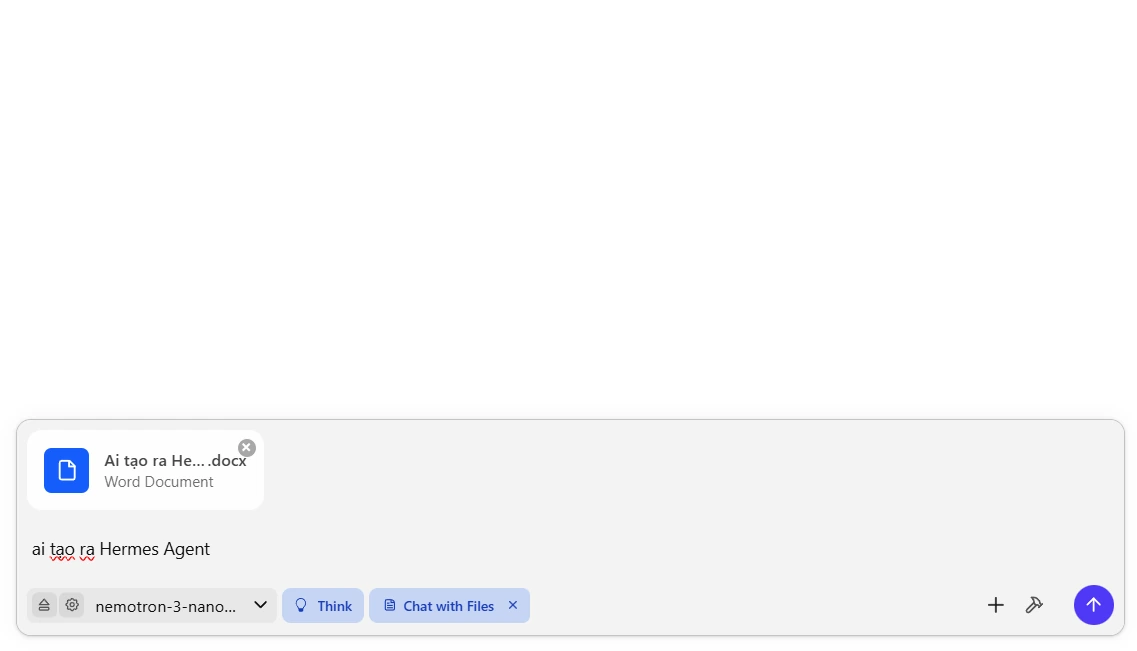
Cách này hữu ích cho báo cáo hoặc tài liệu nội bộ, nhưng retrieval vẫn có thể bỏ sót đoạn. Yêu cầu dẫn vị trí/đoạn nguồn và không coi một câu trả lời trôi chảy là bằng chứng đã đọc toàn bộ tài liệu.
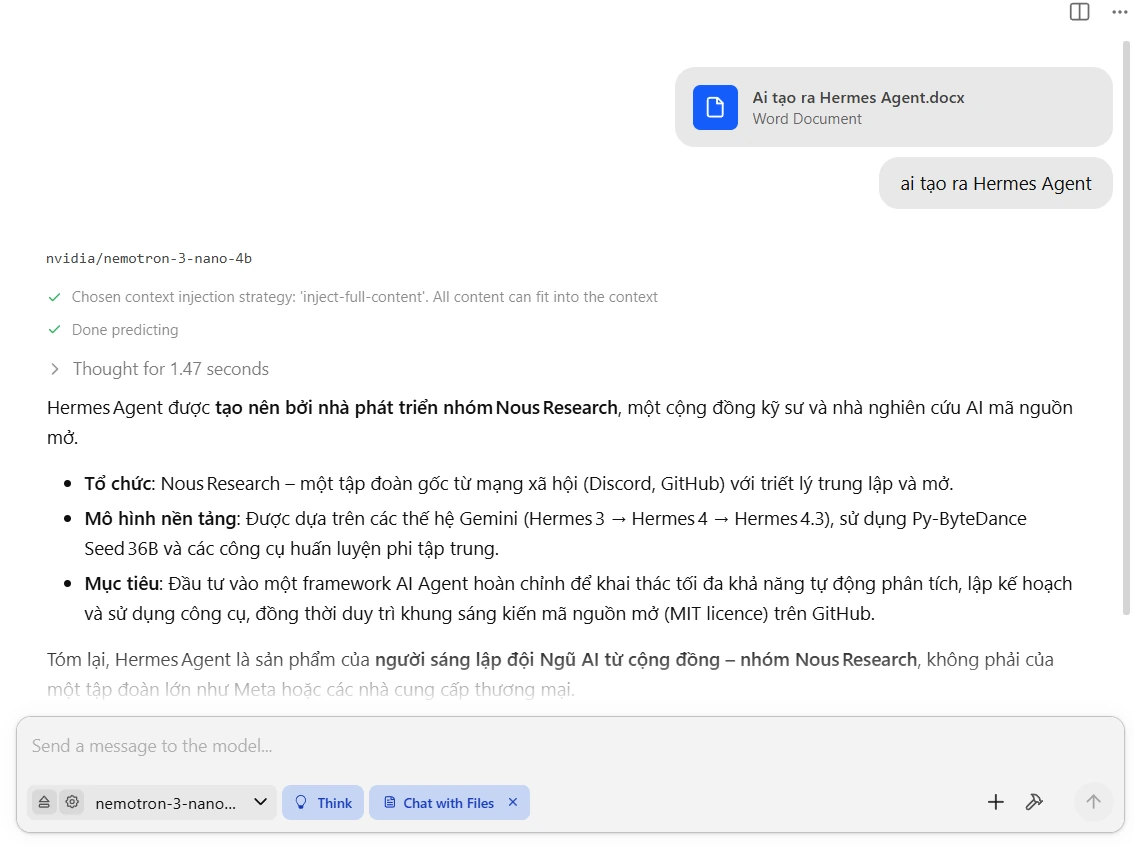
Tính năng 3: Local API Server (Dành cho lập trình viên)
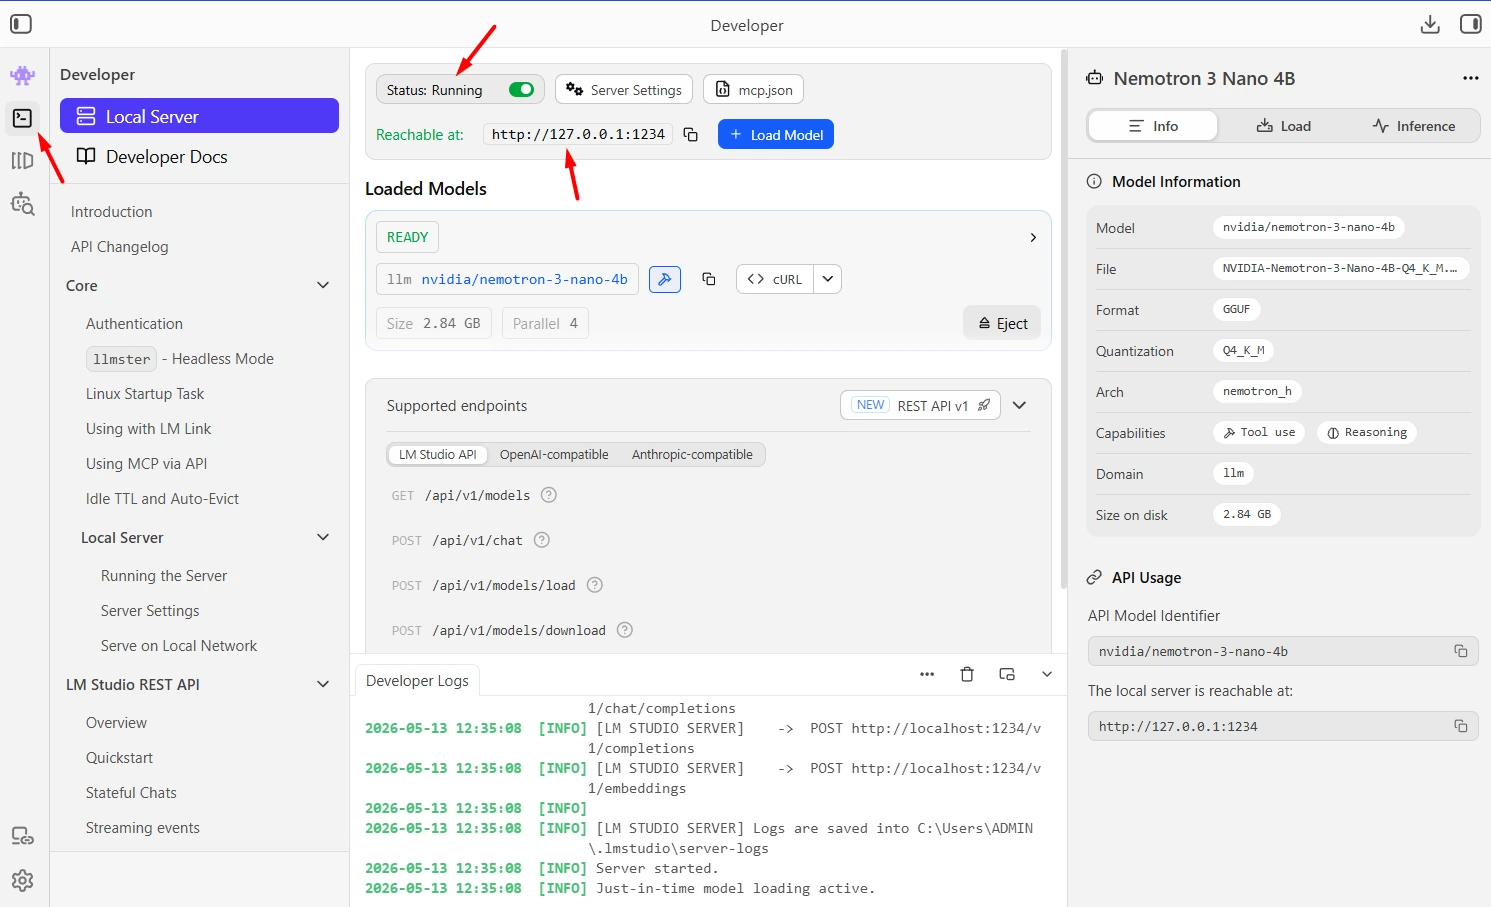
Developer server cung cấp các endpoint được hỗ trợ như chat, responses hoặc embeddings theo engine/model. Đọc OpenAI compatibility trước khi tái dùng client và kiểm tính năng không tương thích.
Bật server theo luồng cơ bản:
- Mở khu vực Developer/Server.
- Khởi động server bằng giao diện hoặc lms server start.
- Kiểm địa chỉ và cổng, thường là http://localhost:1234.
Trong client, đặt base URL tới endpoint LM Studio và dùng model ID từ server. Kiểm streaming, tool schema và định dạng response bằng request nhỏ trước khi nối ứng dụng thật.
Bảo vệ server: bật Require Authentication và token khi chia sẻ truy cập theo docs auth. Serve on Local Network mở phạm vi ngoài loopback; dùng firewall/mạng riêng và quyền tối thiểu. Không đưa token vào frontend hoặc kho mã.
Tính năng 4: GPU Offloading — Tối ưu tốc độ
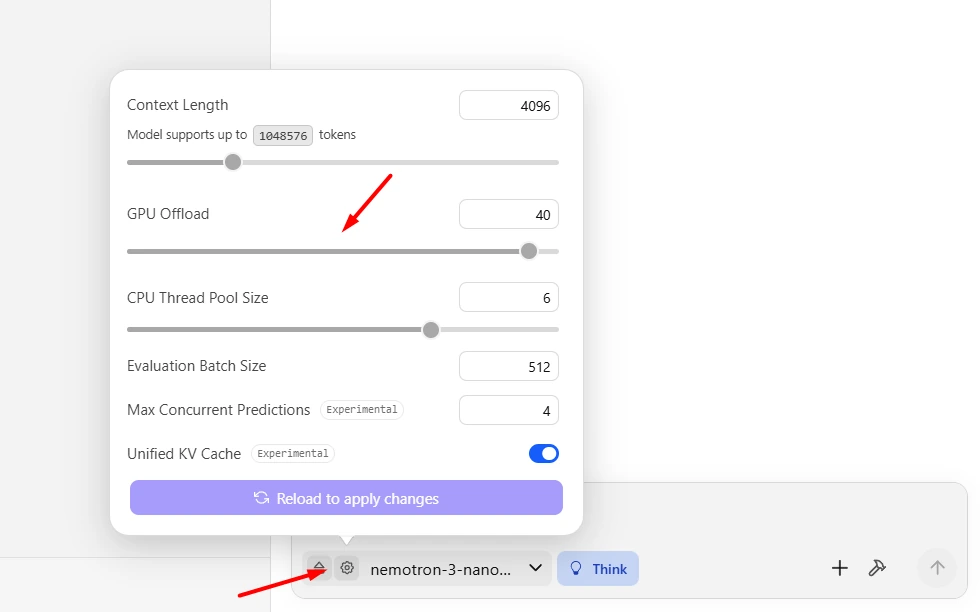
GPU offload phân bổ một phần tính toán/trọng số sang GPU. Nhiều offload hơn có thể tăng tốc khi VRAM và backend phù hợp, nhưng tốc độ còn phụ thuộc context, quant và băng thông; đo token/s và latency trên tác vụ thật.
Khi load, xem Estimated Memory Usage và tùy chọn GPU Offload. Đừng kéo tối đa nếu ước tính vượt bộ nhớ hoặc gây bất ổn; thử mức phù hợp và giữ tài nguyên cho hệ điều hành/ứng dụng khác.
Tính năng 5: LM Link — Kết nối từ xa
LM Link kết nối thiết bị để dùng inference trên máy khác. Model vẫn chạy trên máy phục vụ, không phải đã được chuyển toàn bộ vào laptop đang chat.
Ví dụ laptop có thể gửi request tới máy trạm của bạn. Xác minh đường kết nối, danh tính thiết bị và quyền dữ liệu; kết nối từ xa vẫn là một đường truyền cần quản trị.
Quyền thiết bị và gói LM Link/Bionic có thể thay đổi. Kiểm pricing và trạng thái tài khoản thay vì giữ một con số miễn phí cố định từ ảnh cũ; nhu cầu phục vụ nhiều người cần thiết kế server/auth riêng.
Mẹo sử dụng LM Studio hiệu quả
Tối ưu có đo lường: chọn quant đủ chất lượng, giới hạn context vừa tác vụ, dùng GPU khi phù hợp và đọc ước tính bộ nhớ. Context tối đa trên model card không phải giá trị bắt buộc bật cho mọi request.
Một số thói quen giúp thử nghiệm dễ tái hiện:
- Bắt đầu từ checkpoint vừa máy rồi tăng quy mô khi có lý do.
- Lưu prompt/cấu hình dùng để so sánh, cùng tag và version runtime.
- Theo dõi RAM/VRAM trong lúc load và sinh nội dung.
- Giảm ứng dụng nặng hoặc concurrency nếu tài nguyên thiếu.
Chạy LM Studio trên VPS hoặc máy chủ Linux được không?
Llmster là đường headless cho máy chủ không cần GUI. lms điều khiển daemon, model và server; cổng/API cần cấu hình cùng auth và mạng thay vì chỉ chạy nền rồi bỏ mặc.
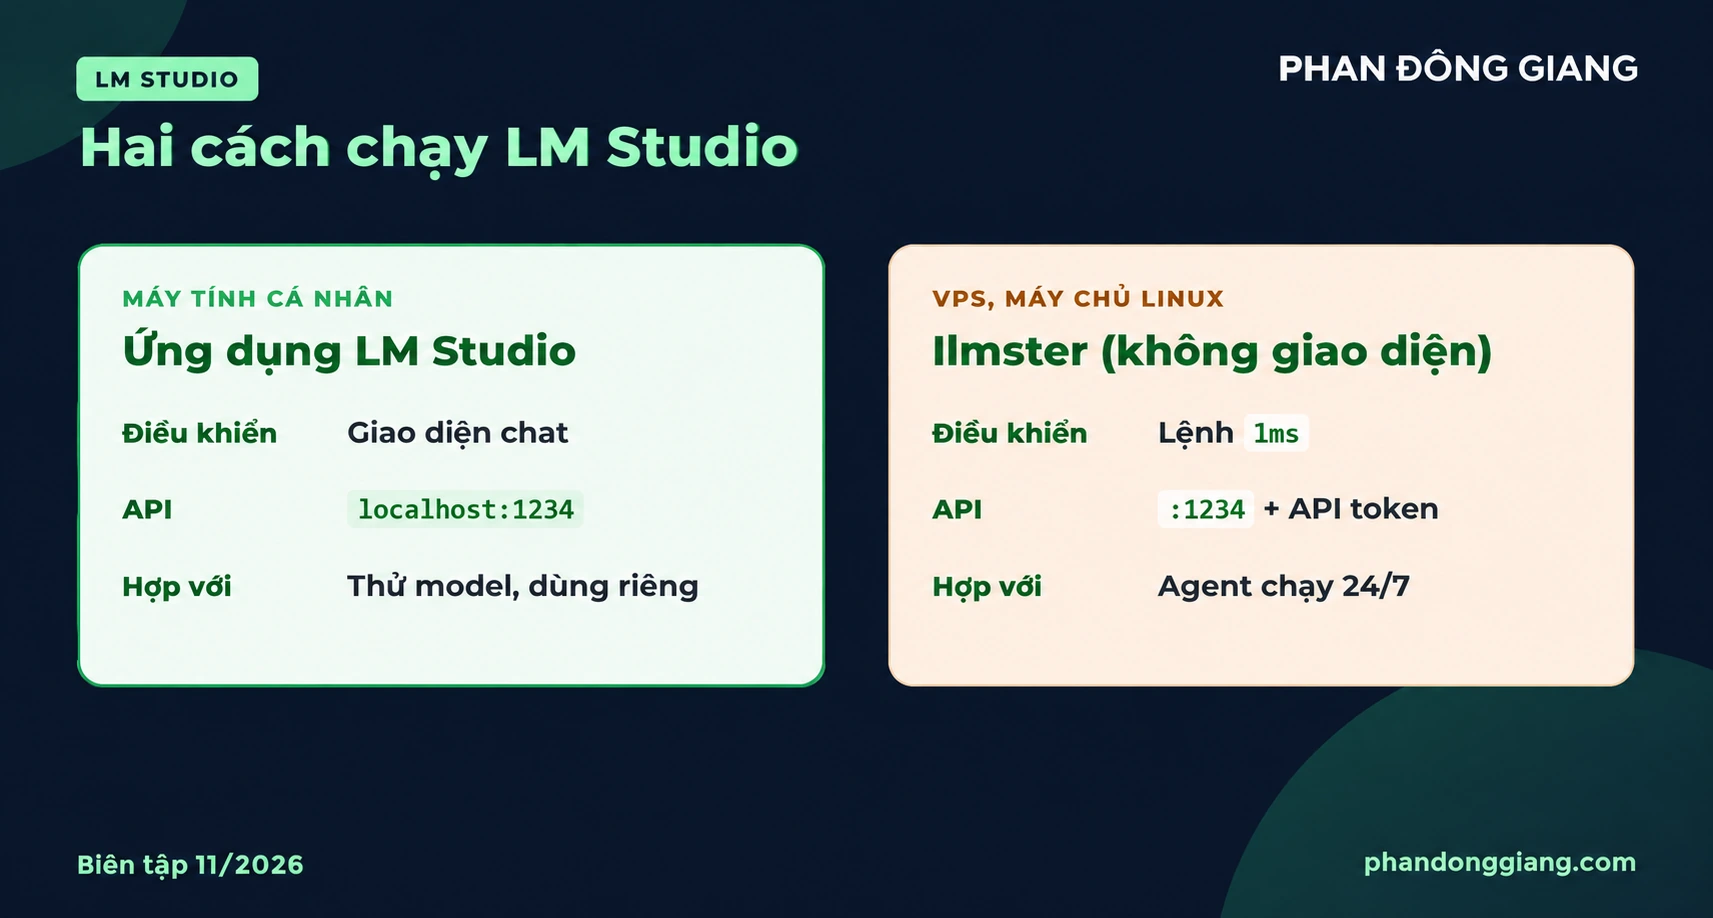
Các lệnh sau là ví dụ từ headless docs. Chỉ thực hiện sau khi kiểm script, yêu cầu máy và quyền của môi trường:
curl -fsSL https://lmstudio.ai/install.sh | bash
lms daemon up
lms get <tên-model>
lms server start --port 1234- Script cài lấy từ lmstudio.ai; đọc trước khi chạy trong hệ thống được quản trị.
- Giữ loopback khi ứng dụng gọi cùng máy. Muốn chia sẻ mạng phải bật xác thực và giới hạn host/IP được truy cập.
- Agent cần context và tool calling phù hợp tác vụ; các gợi ý context của integration không phải mức bảo đảm thành công cho mọi workflow.
Server chỉ có CPU có thể phục vụ model phù hợp nhưng latency cần đo. Nếu dùng máy GPU ở nơi khác hoặc hosted API, hãy ghi rõ dữ liệu rời máy nào và được xử lý tại đâu. Tổng quan local giúp so các phương án.
Khi nào không nên dùng LM Studio?
Không nên ép một checkpoint lớn vào máy không đủ tài nguyên hoặc dùng GUI desktop cho tải chưa được benchmark. Hosted API hoặc runtime phục vụ chuyên biệt có thể phù hợp hơn tùy yêu cầu.
- Máy ngoài danh sách OS/CPU được hỗ trợ cần hướng khác.
- RAM/VRAM thấp giới hạn checkpoint và context; test chất lượng trước khi dùng model nhỏ cho việc khó.
- Workload script/Docker có thể thuận tiện với Ollama hoặc runtime khác.
- API mở rộng mạng và MCP chưa kiểm nguồn có thể làm mất ranh giới riêng tư dù model chạy local.
Kết luận
LM Studio kết hợp GUI và server để bắt đầu inference local thuận tiện. Chất lượng phụ thuộc checkpoint và toàn bộ luồng ứng dụng; kiểm cả phần cứng, auth và license trước khi triển khai. Có thể đọc thêm Ollama và HuggingFace.
Câu hỏi thường gặp
LM Studio có miễn phí không?
Desktop app có điều khoản dùng riêng; inference local không đồng nghĩa các sản phẩm cloud/agent/gói doanh nghiệp đều miễn phí. Kiểm App Terms và bảng giá của sản phẩm bạn định dùng, cùng license checkpoint.
LM Studio khác Ollama ở điểm gì?
LM Studio nổi bật ở GUI quản lý/chat/server, còn Ollama có mã nguồn MIT và luồng CLI/API thuận tiện. Cả hai đều cần checkpoint tương thích; lựa chọn nên dựa vào workflow chứ không chỉ hình thức giao diện.
Làm sao biết mô hình nào phù hợp với máy mình?
Xem nhãn tương thích và Estimated Memory Usage để sàng lọc, rồi nạp và đo thực tế với context dự định dùng. Tính cả cache, hệ điều hành và concurrency chứ không chỉ kích thước file.
Mac dùng chip Intel có dùng được LM Studio không?
Tài liệu hệ thống hiện chỉ nêu Apple Silicon cho macOS, không hỗ trợ MacIntel. Đừng tải nhầm một binary theo nền tảng khác để cố chạy.
Máy tính không có GPU có dùng được không?
Có thể chạy CPU nếu runtime/model hỗ trợ, nhưng tốc độ phụ thuộc máy và checkpoint. Bắt đầu model nhỏ/context ngắn rồi đo, không coi việc load thành công là đã đủ nhanh cho agent.
LM Studio có hỗ trợ tiếng Việt không?
Ngôn ngữ giao diện và năng lực tiếng Việt của checkpoint là hai việc khác nhau. Chọn tùy chọn UI nếu có, rồi thử văn bản tiếng Việt trên model với tiêu chí đúng, tự nhiên và bám dữ liệu.