11 công cụ chạy model local: chọn ứng dụng, API và máy chủ phù hợp
So sánh Ollama, LM Studio, Jan, GPT 4 All, Open WebUI, AnythingLLM, vLLM và các công cụ local theo nhiệm vụ, license và phần cứng.
Công cụ local model giúp bạn tải, nạp và sử dụng trọng số AI trên thiết bị hoặc máy chủ mình quản lý. Có công cụ trực tiếp thực hiện suy luận, có ứng dụng chỉ cung cấp giao diện hoặc nối dữ liệu. Bài này phân biệt 11 lựa chọn để bạn chọn đúng thành phần cho hệ thống; xem thêm tổng quan local model và các nền tảng API.
Ollama đang ở v 0.40.16; LM Studio ở 0.4.28 Build 2. Những dự án còn lại được trình bày theo vai trò và tài liệu chính thức, không dùng số sao GitHub hay một số phiên bản cũ để suy ra chất lượng hiện tại. Kiểm release và điều kiện tương thích trước khi cài.
Tổng quan về local model
“Local” mô tả nơi suy luận: model chạy trong môi trường bạn kiểm soát thay vì phải gửi mọi request đến dịch vụ model bên ngoài. Một ứng dụng local vẫn có thể gọi cloud, tìm kiếm web hoặc tải dữ liệu; lựa chọn backend mới quyết định request thực sự đi đâu. Phần đánh đổi với API có trong bài tổng quan.
Lý do local model ngày càng phổ biến
Bốn động lực thường khiến cá nhân và tổ chức chọn cách triển khai này:
- Chủ động đường đi dữ liệu: có thể xử lý prompt và tài liệu trong máy nếu toàn bộ thành phần liên quan đều chạy nội bộ.
- Đổi cấu trúc chi phí: suy luận bằng phần cứng riêng thường không có hóa đơn token của nhà cung cấp, nhưng vẫn có điện, thiết bị và vận hành.
- Làm việc ngoại tuyến: sau khi tải đủ trọng số và thành phần, các tác vụ không cần dịch vụ mạng có thể chạy khi mất Internet.
- Tự chọn cấu hình: kiểm soát checkpoint, lượng tử hóa, context và các tham số, trong giới hạn runtime và license.
Tiêu chí chọn công cụ local model phù hợp
Hãy viết rõ việc cần làm trước khi chọn phần mềm. Chat cá nhân, API cho agent và máy chủ nhiều người dùng là ba bài toán khác nhau; một giao diện dễ dùng chưa chắc tối ưu phục vụ tải lớn.
- Thao tác: ưu tiên ứng dụng đồ họa nếu muốn tải model và chat nhanh; chọn CLI hoặc thư viện khi cần tự động hóa.
- Định dạng và kiến trúc: kiểm checkpoint được hỗ trợ, không chỉ nhìn đuôi GGUF hay Safetensors; engine còn phải hiểu kiến trúc và tokenizer.
- Kết nối ứng dụng: API, streaming, structured output và tool calling phải phù hợp với client thực tế.
- Phần cứng: chọn backend hỗ trợ đúng CPU, GPU, hệ điều hành và driver; Apple Silicon, NVIDIA và AMD có những đường triển khai khác nhau.
- Tài liệu và công cụ: RAG, embedding, MCP và agent thường cần nhiều thành phần ngoài model. Kiểm đường đi dữ liệu của từng thành phần.
- Duy trì: xem tài liệu, release và phản hồi lỗi của dự án; cộng đồng đông không tự bảo đảm một checkpoint mới đã chạy được.
11 công cụ chạy local model phổ biến hiện nay
Danh sách gồm runtime (Ollama, LM Studio, llama.cpp, MLX-LM), ứng dụng chat (Jan, GPT 4 All), giao diện và RAG (Open WebUI, AnythingLLM), hệ thống phục vụ API (vLLM, LocalAI), cùng trình cài ứng dụng Pinokio. Một số sản phẩm đảm nhiệm nhiều vai trò, nên đây là cách định vị để chọn ban đầu.
| Công cụ | Vai trò chính | Cách dùng | Giấy phép | API local |
|---|---|---|---|---|
| Ollama | Chạy model | Dòng lệnh, ứng dụng nền | MIT | Có, cổng 11434 |
| LM Studio | Chạy model | Giao diện đồ hoạ; llmster cho máy chủ | Miễn phí, mã nguồn đóng | Có, cổng 1234 |
| Jan | Ứng dụng chat trên máy | Giao diện đồ hoạ | Apache 2.0 | Có |
| GPT 4 All | Ứng dụng chat, hỏi tài liệu | Giao diện đồ hoạ | MIT | Có, cổng 4891 |
| Open WebUI | Giao diện web cho Ollama và API khác | Trình duyệt, cài bằng Docker | Open WebUI License (riêng) | Dùng backend khác |
| AnythingLLM | Hỏi đáp tài liệu (RAG), agent | Ứng dụng desktop hoặc Docker | MIT | Có |
| VLLM | Phục vụ model cho nhiều người dùng | Máy chủ, dòng lệnh | Apache 2.0 | Có, tương thích OpenAI |
| Llama.cpp | Thư viện suy luận lõi, định dạng GGUF | Dòng lệnh, thư viện | MIT | Có (llama-server) |
| LocalAI | API tương thích OpenAI cho nhiều backend | Docker, máy chủ | MIT | Có |
| MLX-LM | Chạy và tinh chỉnh model trên Mac | Python, dòng lệnh | MIT | Có (server đơn giản) |
| Pinokio | Cài ứng dụng AI bằng một cú nhấp | Ứng dụng đồ hoạ | MIT | Tuỳ ứng dụng |
Ollama: hợp với lập trình viên và AI agent
Trang chính thức: ollama.com. Runtime dùng MIT; có bản Windows, macOS và Linux. Giấy phép model được tải là điều kiện riêng.
Ollama đóng gói việc lấy trọng số, quản lý model và chạy inference qua CLI cùng dịch vụ nền. Điểm thuận tiện là có thể thử một model bằng lệnh ngắn rồi dùng cùng backend từ ứng dụng khác. Bản phát hành kiểm tra là v 0.40.16.
Hướng dẫn chi tiết: Ollama và cách sử dụng.
Điểm nổi bật:
- CLI tải và chạy checkpoint, chẳng hạn `ollama run gemma 4` khi máy và tag hỗ trợ.
- Dịch vụ mặc định ở `http://localhost:11434`gồm API riêng và một phần tương thích OpenAI.
- Có thể dùng catalog Ollama hoặc model GGUF tương thích; cloud model là lựa chọn riêng, có chính sách và phí riêng.
- Dễ kết nối với Open WebUI, ứng dụng tự viết và nhiều hệ thống agent.
Hạn chế:
- CLI và tham số runtime vẫn cần làm quen; có thể dùng giao diện ngoài khi muốn quản lý chat phong phú hơn.
- Đồng thời nhiều request phụ thuộc `OLLAMA_NUM_PARALLEL`số model nạp và bộ nhớ. Cần đo tải thay vì coi cấu hình mặc định là mức phục vụ cố định.
- GPU offload, quant và context ảnh hưởng lớn đến tốc độ; chạy được không đồng nghĩa đạt độ trễ mong muốn.
Nên cân nhắc cho: người lập trình, người học agent và nhóm cần API local đơn giản, dễ tích hợp.
LM Studio: hợp với người mới bắt đầu
Trang chính thức: lmstudio.ai. Ứng dụng desktop là phần mềm miễn phí theo điều khoản của hãng, mã nguồn đóng; hỗ trợ Windows, Linux và macOS Apple Silicon.
LM Studio cung cấp giao diện tìm, tải, nạp và thử model, thích hợp khi chưa muốn dùng CLI., changelog ghi 0.4.28 Build 2. Hệ sinh thái còn có dịch vụ headless llmster và ứng dụng agent Bionic; phiên bản của Bionic không phải số phiên bản của LM Studio.
Cách tải model và mở API: LM Studio là gì.
Điểm nổi bật:
- Tìm GGUF và, trên Mac phù hợp, model MLX; ứng dụng có ước tính bộ nhớ khi nạp.
- Local server thường dùng cổng 1234, cung cấp API tương thích và tùy chọn yêu cầu token xác thực.
- Có CLI `lms`SDK Python/TypeScript và hướng dẫn tích hợp ứng dụng, MCP hoặc agent. Kiểm chức năng theo endpoint.
Hạn chế:
- Ứng dụng desktop không phải dự án mã nguồn mở; Mac Intel không thuộc cấu hình được hỗ trợ.
- Nếu phục vụ tải lớn, cần benchmark, quản lý hàng đợi và kiểm tài nguyên; một runtime máy chủ có thể phù hợp hơn giao diện desktop.
Nên cân nhắc cho: người mới, người làm nội dung và lập trình viên muốn so model qua giao diện trước khi tích hợp API.
Jan: ứng dụng chat trên máy, chú trọng riêng tư
Trang chính thức: jan.ai. Jan phát hành theo Apache 2.0 và có ứng dụng cho Windows, macOS, Linux.
Jan cung cấp trải nghiệm hội thoại trên máy với mã nguồn công khai. Khi chọn backend local, dữ liệu trò chuyện có thể được xử lý trong máy; nếu chọn dịch vụ model từ xa, request vẫn đi đến dịch vụ đó. Tài liệu quyền riêng tư là nơi kiểm dữ liệu ứng dụng lưu hoặc gửi, thay vì chỉ suy ra từ chữ “local”.
Điểm nổi bật:
- Có thể tự xem mã nguồn và sử dụng model trên máy.
- Hỗ trợ nối công cụ qua MCP theo cấu hình và quyền được cấp.
- Cho phép chọn thêm backend API khi cần một model không chạy trên thiết bị.
Hạn chế:
- Định hướng chính là trải nghiệm cá nhân, không phải thay thế đầy đủ hệ thống phục vụ API tải lớn.
- Tích hợp cần kiểm theo phiên bản, backend và model; không nên giả định mọi kết nối Ollama đều có cấu hình tương đương trong Jan.
Nên cân nhắc cho: người muốn ứng dụng chat cá nhân với khả năng kiểm soát dữ liệu và lựa chọn backend.
GPT 4 All: dễ cài, có sẵn hỏi đáp tài liệu
Trang chính thức: GPT 4 All. Dự án của Nomic dùng MIT, có gói desktop cho những hệ điều hành được trang tải liệt kê.
GPT 4 All kết hợp chat local với LocalDocs: chọn tài liệu để tạo chỉ mục và truy xuất đoạn phù hợp khi hỏi. Đây là cách thuận tiện để thử hỏi đáp PDF hoặc văn bản mà không tự lắp pipeline RAG. Tuy vậy, hãy kiểm repository và model được hỗ trợ trước khi chọn cho dự án mới; khả năng của một bản cài cũ không đại diện catalog model hiện nay.
Điểm nổi bật:
- Cài và sử dụng qua giao diện desktop.
- LocalDocs hỗ trợ quy trình hỏi đáp trên tập tài liệu cá nhân.
- Có thể chạy model nhỏ bằng CPU khi không có GPU phù hợp.
- API server tương thích OpenAI dùng cổng 4891 và chỉ lắng nghe trên loopback theo tài liệu.
Hạn chế:
- Cần kiểm mức duy trì và khả năng hỗ trợ kiến trúc mới, đặc biệt trước khi tải checkpoint vừa phát hành.
- Tính năng chat/RAG cá nhân không tự tạo thành nền tảng agent phức tạp hoặc máy chủ nhiều người dùng.
Nên cân nhắc cho: học sinh, giáo viên và người cần hỏi tài liệu riêng với ít công đoạn thiết lập.
Open WebUI: giao diện web giống ChatGPT
Trang chính thức: openwebui.com. Dự án dùng Open WebUI License, có điều kiện riêng về thương hiệu; không nên gọi chung là BSD-3 thuần.
Open WebUI là lớp giao diện hội thoại, quản lý người dùng và tài liệu trước các backend như Ollama hoặc endpoint tương thích OpenAI. Phần xử lý model vẫn cần runtime hoặc nhà cung cấp phía sau. Vì vậy, cài giao diện không thay thế việc chọn model và nơi inference.
Điểm nổi bật:
- Giao diện web có tài khoản và quản lý quyền theo cấu hình.
- Hỗ trợ các quy trình tài liệu, RAG và kết nối tìm kiếm.
- Có thể self-host và gom nhiều backend vào một nơi thao tác.
Hạn chế:
- Cần triển khai, lưu dữ liệu, cập nhật và cấu hình dịch vụ, thường qua container.
- Vẫn phải cung cấp tài nguyên cho backend model hoặc thanh toán API từ xa.
- Đọc điều khoản license và ngoại lệ thương hiệu khi cung cấp dịch vụ cho tổ chức hoặc khách hàng.
Nên cân nhắc cho: nhóm muốn cổng AI nội bộ hoặc người đã có Ollama nhưng cần trải nghiệm web nhiều chức năng hơn.
AnythingLLM: hỏi đáp tài liệu (RAG) và agent
Trang chính thức: anythingllm.com. Mã dự án AnythingLLM sử dụng MIT.
AnythingLLM tổ chức tài liệu và hội thoại theo workspace, đồng thời cung cấp RAG và công cụ agent. Nó có thể nối runtime local như Ollama, LM Studio hoặc nhà cung cấp cloud; model chat, embedding và vector store cần được chọn nhất quán với yêu cầu dữ liệu.
Điểm nổi bật:
- Workspace giúp tách tài liệu giữa dự án hoặc nhóm.
- Cho phép chọn nhiều nhà cung cấp local và cloud.
- Agent Flows hỗ trợ tạo luồng xử lý bằng giao diện.
- Nhận nhiều loại nội dung như PDF, tài liệu văn phòng và trang web, tùy bộ chuyển đổi đang dùng.
Hạn chế:
- Ứng dụng không xóa nhu cầu inference và tài nguyên backend.
- Chất lượng RAG còn phụ thuộc trích xuất, chunking, embedding, truy xuất và nguồn tài liệu; cần kiểm câu trả lời kèm bằng chứng.
Nên cân nhắc cho: nhóm hỗ trợ khách hàng, nghiên cứu hoặc doanh nghiệp muốn thử trợ lý trên kho tài liệu riêng.
VLLM: phục vụ model cho nhiều người dùng
Trang chính thức: vllm.ai. vLLM sử dụng Apache 2.0.
VLLM tập trung suy luận và phục vụ model với hiệu suất cao, sử dụng quản lý KV cache kiểu PagedAttention cùng batching để tận dụng thiết bị. Tài liệu cài đặt có nhánh GPU, CPU và TPU; hỗ trợ model và phần cứng phải kiểm theo bản phát hành, không suy ra chỉ từ định dạng trọng số.
Điểm nổi bật:
- Có cơ chế phân phối trên nhiều GPU khi kiến trúc và cấu hình phù hợp.
- Cung cấp server tương thích OpenAI cho ứng dụng gọi API.
- Thích hợp thử tối ưu throughput và hàng đợi khi nhiều người dùng chung backend.
Hạn chế:
- Đòi hỏi hiểu môi trường Python, driver, bộ nhớ và cấu hình phục vụ.
- Một ứng dụng chat desktop thường dễ bắt đầu hơn nếu chỉ cần thử một model trên máy cá nhân.
Nên cân nhắc cho: kỹ sư hạ tầng và nhóm xây API inference nội bộ hoặc dịch vụ nhiều người dùng.
Llama.cpp: thư viện lõi chạy model GGUF
Repository chính thức: ggml-org/llama.cpp. Thư viện phát hành theo MIT.
Llama.cpp là bộ công cụ suy luận C/C++ do Georgi Gerganov khởi xướng, gắn với hệ sinh thái định dạng GGUF. Nhiều ứng dụng local tích hợp engine này hoặc biến thể của nó. Dự án phát hành thường xuyên; kiểm release đúng kiến trúc model thay vì cài theo một số bản đóng đinh từ tháng trước.
Điểm nổi bật:
- Hỗ trợ nhiều backend CPU/GPU, trong đó có CUDA, Metal và các đường triển khai khác tùy bản build.
- Có CLI và `llama-server`giảm nhu cầu phụ thuộc một ứng dụng desktop hoàn chỉnh.
- Cho phép điều chỉnh quant, context, batch và GPU offload ở mức chi tiết.
Hạn chế:
- Phải hiểu các cờ và cách build hoặc chọn binary phù hợp máy.
- Muốn trải nghiệm chat đồ họa hoàn chỉnh thường cần thêm lớp giao diện.
Nên cân nhắc cho: người phát triển cần kiểm soát inference, nghiên cứu tối ưu hoặc tích hợp vào ứng dụng riêng.
LocalAI: API tương thích OpenAI cho nhiều loại model
Trang chính thức: localai.io. LocalAI sử dụng MIT.
LocalAI cung cấp một lớp API tương thích trước nhiều backend xử lý văn bản, ảnh hoặc âm thanh. Mục tiêu là tái sử dụng client quen thuộc trên hạ tầng tự quản lý. Mức tương thích vẫn cần kiểm cho từng endpoint, schema và backend; không phải chỉ đổi base URL là mọi tính năng hoạt động giống dịch vụ gốc.
Điểm nổi bật:
- Tập hợp nhiều loại tác vụ sau một dịch vụ API.
- Có hướng triển khai bằng container và hệ thống điều phối.
- Giúp chuyển một số ứng dụng đang dùng client OpenAI sang backend tự host, sau khi kiểm tương thích.
Hạn chế:
- Cấu hình model, backend và tài nguyên phức tạp hơn ứng dụng chat cho người mới.
- Tốc độ, chất lượng và tính năng thực tế phụ thuộc engine cùng checkpoint đã chọn.
Nên cân nhắc cho: lập trình viên muốn giữ giao diện API quen thuộc nhưng chủ động nơi phục vụ model.
MLX-LM: chạy model trên Mac Apple Silicon
Repository chính thức: ml-explore/mlx-lm. Dự án dùng MIT.
MLX-LM xây trên MLX để sinh văn bản và fine-tune LLM, hướng tới Apple Silicon. Unified memory và backend MLX giúp tận dụng cấu trúc bộ nhớ của Mac phù hợp. Đây là bộ công cụ Python/CLI; LM Studio cũng có thể dùng engine MLX cho model tương thích trên Mac.
Điểm nổi bật:
- Tập trung tối ưu cho nền tảng Apple Silicon.
- Hỗ trợ inference và tinh chỉnh bằng Python hoặc CLI.
- Tích hợp quy trình tải checkpoint từ Hugging Face, với model và quant được hỗ trợ.
Hạn chế:
- Không phải lựa chọn thay thế chung cho hệ NVIDIA/Windows.
- Cần kỹ năng lập trình và hiểu giới hạn RAM, context của thiết bị.
Nên cân nhắc cho: người dùng Mac làm phát triển hoặc thử tinh chỉnh model trong khả năng bộ nhớ của máy.
Pinokio: cài ứng dụng AI bằng một cú nhấp
Trang chính thức: pinokio.co. Pinokio dùng MIT, có bản Windows, macOS và Linux.
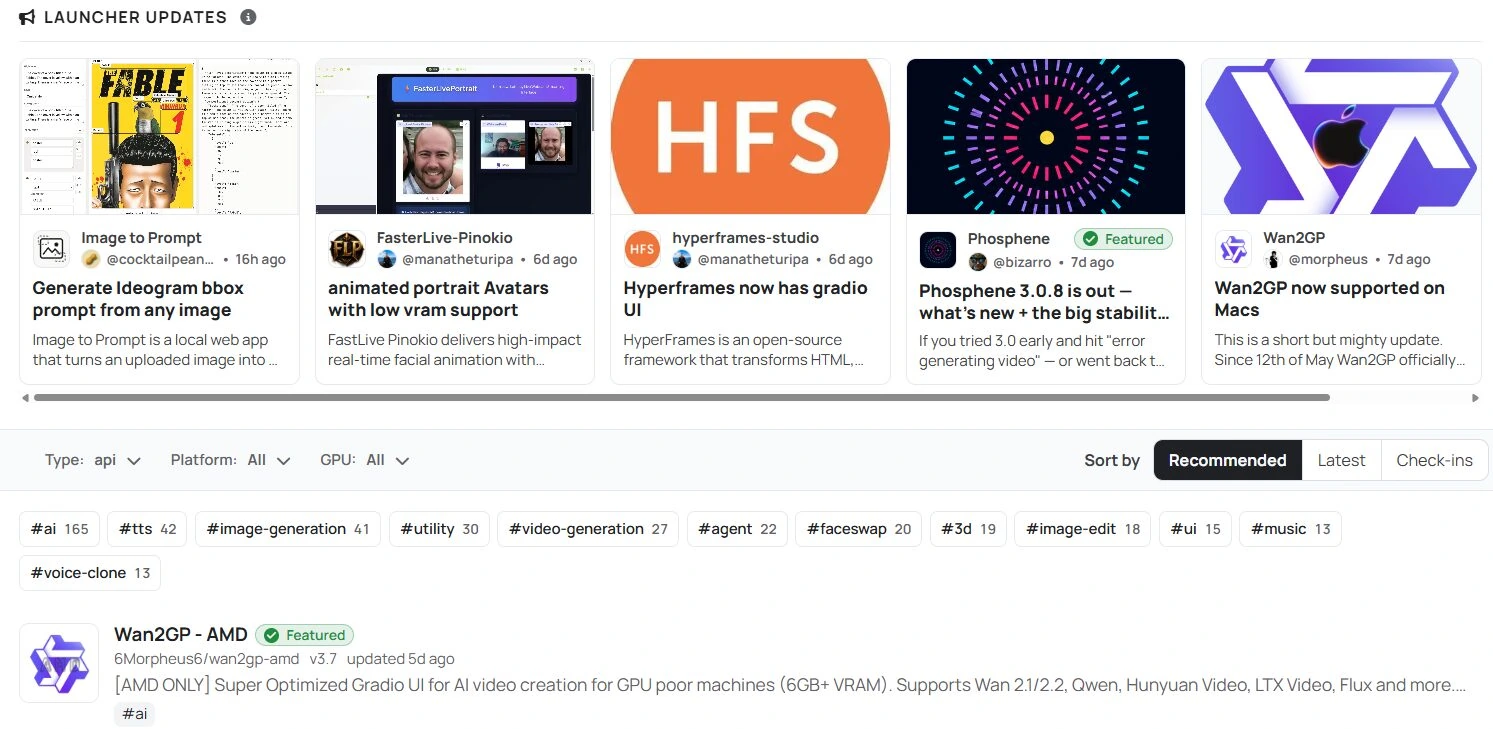
Pinokio tự động hóa các bước cài và khởi động ứng dụng AI bằng script, từ tải mã đến chuẩn bị dependency. Nó có ứng dụng LLM cũng như tạo ảnh, video và giọng nói. Bản thân Pinokio không quyết định khả năng suy luận: cấu hình phần cứng và yêu cầu của ứng dụng bên trong vẫn phải được đáp ứng.
Điểm nổi bật:
- Giảm thao tác thiết lập lặp lại cho các ứng dụng được hỗ trợ.
- Có danh mục script từ tác giả hoặc cộng đồng.
- Thuận tiện thử nhiều nhóm công cụ AI trong cùng một môi trường quản lý.
Trước khi cài: xem tác giả, repository và các lệnh trong script. Script có thể tải và thực thi phần mềm bằng quyền tài khoản của bạn; khả năng cài một chạm không thay cho việc tin cậy nguồn.
Nên cân nhắc cho: người thử nhiều ứng dụng và muốn giảm công việc cài đặt thủ công.
Nên chọn công cụ nào cho từng trường hợp sử dụng?
Hãy chọn một điểm bắt đầu theo nhiệm vụ, rồi bổ sung thành phần khi có nhu cầu. Có thể ghép Ollama với Open WebUI hoặc runtime với AnythingLLM; không cần tìm một sản phẩm bao trọn mọi chức năng.
- Chat lần đầu: thử LM Studio hoặc Jan với một checkpoint nhỏ.
- API cho ứng dụng: Ollama hoặc LM Studio; dùng llama.cpp khi cần can thiệp sâu hơn.
- Hỏi kho tài liệu: AnythingLLM; GPT 4 All LocalDocs cho thử nghiệm cá nhân.
- Nhiều người dùng: benchmark vLLM hoặc backend phù hợp; giao diện Open WebUI có thể đứng phía trước.
- Muốn xem mã nguồn: xem Jan, Ollama hoặc llama.cpp và license từng thành phần.
- Thử ứng dụng đa phương tiện: Pinokio, sau khi kiểm script.
- Mac Apple Silicon: cân nhắc LM Studio, Ollama hoặc MLX-LM theo model cần chạy.
- CPU là chính: thử quant nhỏ trên Ollama, LM Studio, GPT 4 All hoặc llama.cpp và đo tốc độ.
Gợi ý cấu hình phần cứng cho local model
Bộ nhớ cần cho trọng số chỉ là phần đầu của cấu hình. KV cache tăng cùng context và số phiên, runtime có overhead, còn tốc độ phụ thuộc băng thông bộ nhớ và khả năng offload. Một file vừa ổ đĩa chưa có nghĩa máy đủ RAM để chạy.
Yêu cầu tối thiểu do nhà phát triển công bố
- LM Studio: yêu cầu hệ thống khuyến nghị 16 GB RAM; Windows x 64 cần AVX 2, GPU 4 GB VRAM là mức khuyến nghị. Mac yêu cầu Apple Silicon và macOS 14 trở lên; có đường Windows ARM và Linux theo tài liệu.
- Ollama: tài liệu Windows nêu Windows 10 22 H 2 trở lên, ít nhất 4 GB cho phần cài đặt chưa gồm model. GPU cần đúng dòng được hỗ trợ và driver phù hợp.
- vLLM: theo đúng nhánh cài đặt chính thức cho GPU, CPU hoặc TPU; không dùng một mức RAM desktop để ước lượng máy chủ.
Cách ước lượng trên máy của bạn
- Khởi đầu bằng quant khoảng 4-bit với model nhỏ và context vừa đủ; đo chất lượng trước khi tăng kích thước.
- Theo dõi ước tính của LM Studio hoặc `ollama ps`cùng RAM/VRAM thực tế khi chạy.
- Trên Apple Silicon, RAM dùng chung cho cả hệ điều hành, CPU và GPU; chừa phần cho ứng dụng khác.
- Tăng context, batch hay số phiên có thể làm một cấu hình vốn chạy được trở nên thiếu bộ nhớ.
Chạy công cụ local model trên VPS
Máy chủ Linux có thể chạy Ollama, llmster, llama.cpp, vLLM, LocalAI hoặc lớp giao diện web khi đáp ứng dependency và phần cứng. VPS chỉ có CPU thường phù hợp model nhỏ hoặc phần điều phối agent hơn là inference model lớn. Muốn thuê GPU phải tính cả bộ nhớ, thời gian tải model và chi phí nhàn rỗi.
- Giữ endpoint ở loopback khi chỉ dùng nội bộ. Nếu cần truy cập từ xa, thêm xác thực, TLS, giới hạn mạng và chính sách quyền phù hợp.
- LM Studio có llmster/headless; Ollama có cách cài dịch vụ trên Linux. Dùng hướng dẫn chính thức phù hợp hệ điều hành.
- Đối chiếu trade-off thiết bị cá nhân và máy chủ tại bài local model.
Kết luận
Công cụ nên được chọn theo việc cần làm: giao diện để học và chat, runtime để cấp API, RAG để nối tài liệu, hay engine máy chủ để phục vụ tải. Sau đó chọn model có trọng số mở tương thích; phần mềm chạy model không tự bảo đảm chất lượng câu trả lời.
Bắt đầu bằng một nhu cầu cụ thể và một bộ câu hỏi nhỏ. Khi đã đo tốc độ, độ đúng và tài nguyên, bạn mới có căn cứ để mở rộng sang agent, RAG hoặc phục vụ nhóm.
Câu hỏi thường gặp
Local model có cần Internet không?
Cần mạng để tải ứng dụng, trọng số và cập nhật. Khi đã chuẩn bị đủ, inference local có thể ngoại tuyến; web search, API cloud hoặc dịch vụ ngoài vẫn cần kết nối.
Dữ liệu của tôi có thực sự an toàn khi dùng local model không?
Bạn có thể giữ dữ liệu suy luận trong máy, nhưng an toàn còn phụ thuộc quyền tool, plugin, log, endpoint và các dịch vụ được nối. Xem request có đi qua cloud không, giới hạn quyền và tránh mở một API không xác thực ra Internet.
Local model có miễn phí hoàn toàn không?
Có công cụ và checkpoint cho phép dùng không thu phí license, nhưng phần cứng, điện, ổ đĩa và vận hành vẫn có giá. Đọc điều kiện của model và tính toàn bộ chi phí model miễn phí.
Local model có thể hiểu và trả lời bằng tiếng Việt không?
Nhiều model đa ngôn ngữ trả lời được tiếng Việt, nhưng phải kiểm theo checkpoint, quant và tác vụ. Thử các câu hỏi thật có thuật ngữ và ngữ cảnh của bạn; đừng suy ra chất lượng chỉ từ tên họ Qwen, Gemma hay Llama.
Máy tính của tôi không có GPU rời, có dùng được local model không?
Có thể chạy CPU bằng các runtime hỗ trợ, đặc biệt với model nhỏ đã quant. Độ trễ có thể cao; hãy bắt đầu context ngắn, đo tốc độ và giữ đủ RAM thay vì chỉ nhìn dung lượng file.