Gemma 4 là gì? Kích thước, Apache-2.0 và cách chạy local
Tìm hiểu Gemma 4 của Google, input/output từng kích thước, bộ nhớ, cách tải và dùng API hoặc triển khai nội bộ.
Gemma 4 là họ model mở trọng số của Google DeepMind, được phát hành theo Apache-2.0 ở các checkpoint chính chủ đã kiểm tra. Các kích thước E2B, E4B,12B,26B-A4B và 31B phục vụ cấu hình khác nhau. Phương thức đầu vào, context và bộ nhớ phải xem theo bản, không chỉ thương hiệu Gemma.
Bài rà đến 20/11/2026 từ model card Gemma 4, Google DeepMind và checkpoint 31B. Xem thêm model AI, API key và local model.
Tổng quan về Gemma 4
Gemma là họ checkpoint có thể tải để triển khai, khác các dịch vụ Gemini. Gemma 4 là dòng tổng quát hiện được kiểm tra; EmbeddingGemma hoặc Diffusion Gemma là nhánh chuyên biệt, không phải thông báo Gemma 5.
Gemma 4 là gì?
Gemma 4 được giới thiệu trong 2026, hướng tới nhiều cấu hình từ thiết bị nhỏ tới GPU. Điều đó không có nghĩa mọi kích thước đều chạy được trên điện thoại; chọn checkpoint và runtime phù hợp.
Các bản nhận dữ liệu theo card và tạo đầu ra văn bản. E2B/E4B/12B có hỗ trợ audio theo cấu hình, còn khả năng vision, context và bản instruct/pretrained phải xác nhận đúng model. Model đa ngôn ngữ vẫn cần kiểm tra tiếng Việt theo tác vụ.
Nguồn gốc và mối liên hệ với Gemini 3
Google mô tả Gemma 4 sử dụng nghiên cứu liên quan Gemini, nhưng hai dòng có cách cung cấp khác nhau. Không suy ra Gemma là toàn bộ Gemini được thu nhỏ hay có cùng năng lực, dữ liệu và quyền.
Có thể kết hợp hosted model cho một số việc và Gemma local cho nhiệm vụ khác, nếu chính sách dữ liệu cho phép. Cần đo chi phí và chất lượng thay vì mặc định một dòng luôn mạnh hơn mọi bản của dòng kia.
Điểm khác biệt của Gemma 4 so với các thế hệ Gemma trước
Các thế hệ Gemma trước có card/license riêng. Một thay đổi cần đọc ở Gemma 4 là Apache-2.0; không lấy điều khoản Gemma cũ áp cho checkpoint mới hoặc ngược lại.
- Giấy phép Apache 2.0: các thế hệ trước dùng điều khoản sử dụng riêng của Gemma; Gemma 4 chuyển sang Apache 2.0, cho phép dùng thương mại, sửa đổi và phân phối lại theo điều kiện của giấy phép.
- Điểm suy luận và lập trình tăng mạnh: theo model card, Gemma 4 31B đạt 89,2% AIME 2026 (Gemma 3 27B: 20,8%), 84,3% GPQA Diamond (42,4%) và Codeforces ELO 2150 (110).
- Chế độ suy luận (thinking) bật tắt được: model có thể suy nghĩ từng bước trước khi trả lời, tuỳ chỉnh theo yêu cầu.
- Âm thanh đầu vào: E2B, E4B và 12B nhận âm thanh trực tiếp, điều Gemma 3 không có.
- Hỗ trợ system prompt và gọi hàm gốc: thuận tiện khi xây trợ lý hoặc agent gọi công cụ bên ngoài.
Các phiên bản của Gemma 4
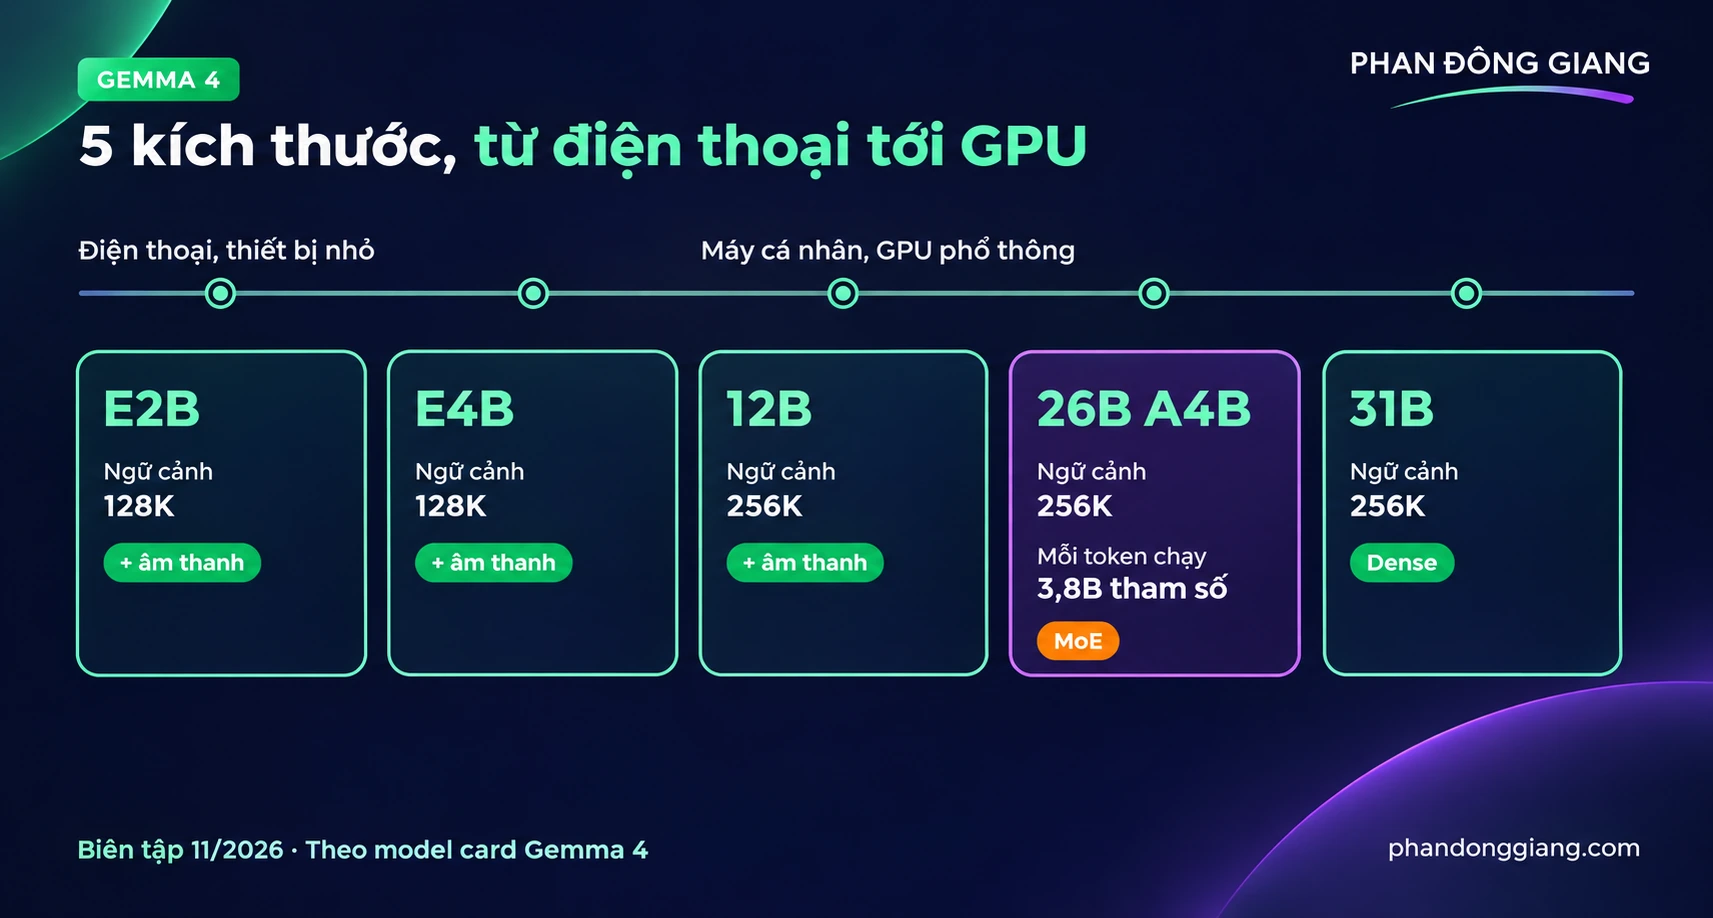
Danh mục gồm bản nhỏ hiệu dụng, bản dense và bản MoE. Việc 12B xuất hiện sau đợt đầu không biến nó thành thế hệ khác; ngày repo chỉ là một dấu mốc phát hành cần ghi đúng ngữ cảnh.
Gemma 4 E2B và E4B: cho điện thoại và thiết bị biên
E chỉ quy mô hiệu dụng theo thiết kế của bản nhỏ, không tự bằng dung lượng file hoặc VRAM cần dùng. Runtime cho di động/edge có thể dùng bản tối ưu khác checkpoint BF16.
Context 128K là giới hạn khả năng theo model, không phải cấu hình mọi điện thoại đều chạy được ở tốc độ tốt. Tăng context có thể làm bộ nhớ và thời gian tăng đáng kể.
Gemma 4 12B: bản Unified không cần bộ mã hoá riêng
Bản12B Unified có cách xử lý đa phương thức riêng theo card. Số bộ nhớ cho weights lượng tử chỉ là một phần dự toán; cần thêm runtime, cache, đầu vào audio/ảnh và tải đồng thời.
Gemma 4 26B A4B: MoE cân bằng tốc độ và chất lượng
26B-A4B là MoE: tổng weights lớn hơn số active mỗi token. Cần giữ weights phù hợp trong bộ nhớ; không suy rằng bản này có thể tải như model 4B chỉ vì active khoảng 4B.
Context dài có ích cho mã/tài liệu nhưng không bảo đảm truy hồi mọi chi tiết. So với 31B cần đo cả chất lượng, bộ nhớ và độ trễ trên cùng tác vụ, không chỉ vài điểm benchmark.
Gemma 4 31B Dense: bản dense nhiều tham số nhất
31B là bản dense lớn trong dòng, hướng tới cấu hình có đủ tài nguyên. Các điểm toán/coding trong card là kết quả của Google với điều kiện xác định; không thay bộ test của bạn.
Điểm Arena tại ra mắt là ảnh chụp thời điểm, không phải vị trí hiện hành. Đổi lại chất lượng, bản lớn có thể cần thêm RAM/VRAM và compute.
Những tính năng nổi bật của Gemma 4
Các khả năng gồm reasoning, đa phương thức, system prompt, tool/JSON theo model và runtime. Khi xây agent, phần mềm ngoài vẫn phải thực thi công cụ và quản lý quyền.
- Đa phương thức: mọi kích thước nhận văn bản và hình ảnh (nhiều tỷ lệ, độ phân giải); E2B, E4B, 12B nhận thêm âm thanh; trang Gemma 4 có ghi thêm khả năng hiểu video.
- Chế độ suy luận: model có thể suy nghĩ từng bước trước khi trả lời; chế độ này bật tắt được để cân bằng tốc độ và độ chính xác.
- Ngữ cảnh dài: 128K token ở E2B, E4B và 256K token ở 12B, 26B A4B, 31B.
- Lập trình: điểm LiveCodeBench v6 của bản 31B là 80,0% theo model card, đủ để làm trợ lý viết mã ngoại tuyến.
- Gọi hàm và xuất JSON: hỗ trợ gọi hàm gốc và system prompt, nền tảng để xây agent tự lập kế hoạch và gọi API bên ngoài.
- Chạy trên thiết bị cá nhân: chạy được trên điện thoại, laptop hay máy chủ riêng mà không cần Internet, nên dữ liệu không phải gửi lên dịch vụ bên ngoài.
- Đa ngôn ngữ: huấn luyện trên hơn 140 ngôn ngữ. Google không công bố điểm riêng cho tiếng Việt, nên hãy thử trên dữ liệu của bạn trước khi dùng thật.
Gemma 4 hoạt động trên những thiết bị nào?
Ước lượng bộ nhớ cần phân biệt weights với tổng phục vụ. Bảng precision giúp tính ban đầu nhưng chưa gồm KV cache, processor và concurrency; đừng coi dung lượng Q4 là cấu hình production đủ.
| Kích thước | BF16 (16-bit) | SFP8 (8-bit) | Q4_0 (4-bit) |
|---|---|---|---|
| E2B | 11,4 GB | 5,7 GB | 2,9 GB |
| E4B | 17,9 GB | 8,9 GB | 4,5 GB |
| 12B | 26,7 GB | 13,4 GB | 6,7 GB |
| 26B A4B | 57,7 GB | 28,8 GB | 14,4 GB |
| 31B | 69,9 GB | 34,9 GB | 17,5 GB |
Chạy trực tiếp trên điện thoại thông minh
Bản mobile được tối ưu qua runtime phù hợp và có thể khác bản weights tổng quát. Những mức RAM Google công bố chỉ áp dụng cho package/cấu hình đó, không phải bảo đảm mọi điện thoại.
Ứng dụng edge có thể xử lý offline sau khi đã tải đủ model/phần mềm. Cần kiểm tra cả tính năng speech/vision và các kết nối ngoài mà ứng dụng bật.
Máy tính cá nhân có GPU
Với GPU cá nhân, chọn precision và context theo bộ nhớ thực. Một model weights vừa 8GB không có nghĩa có thể dùng toàn bộ context với GPU 8GB.
CPU có thể phục vụ một số bản nhưng cần đo độ trễ. Bắt đầu từ model nhỏ và context ngắn, sau đó tăng dần thay vì tải bản lớn nhất ngay.
Có thể dùng Ollama, LM Studio, llama.cpp hoặc engine được hỗ trợ. Ưu tiên quant do Google công bố hoặc nguồn được kiểm tra; xác nhận engine/version hiểu kiến trúc và template Gemma 4.
Máy chủ và môi trường đám mây
Trên server, tính cả weights, KV cache, prefill và concurrency. Một GPU 80GB có thể phù hợp một cấu hình nhưng không phải cam kết đủ cho mọi context và tải.
Tải checkpoint từ kho chính chủ và phục vụ bằng runtime tương thích. Apache-2.0 cho quyền trong điều kiện license; giữ dữ liệu nội bộ còn phụ thuộc cách cấu hình API, log và tool ngoài.
Gemma 4 được triển khai như thế nào?
Ba đường dùng là download weights, runtime local và hosted API nếu model đó được provider phục vụ. Người mới nên thử bản vừa tài nguyên; đội tích hợp API cần kiểm tra ID/quota hiện hành.
Tải qua Hugging Face và Kaggle
Hugging Face và Kaggle là kênh phát hành, còn quyền tải và chi phí compute phụ thuộc checkpoint, môi trường và tài khoản.
Trên Hugging Face:
- Truy cập trang tổ chức Google trên Hugging Face (huggingface.co/google) và chọn repo, ví dụ google/gemma-4-E4B-it. Kiểm tra trạng thái tải và quyền truy cập ngay trên trang model.
- Cài thư viện: pip install --upgrade transformers accelerate. Dùng bản Transformers mới, vì bản cũ chưa nhận kiến trúc Gemma 4.
- Nếu GPU ít bộ nhớ, dùng bản QAT Q4_0 do Google phát hành sẵn, hoặc cài thêm pip install bitsandbytes để lượng tử hoá 4-bit.
- Tải model và chạy thử qua pipeline của Transformers để có kết quả đầu tiên.
Kaggle có thể giúp thử notebook mà không tải toàn bộ về máy. Vẫn cần chọn GPU, RAM và version thư viện đủ hỗ trợ, đồng thời đọc quota tài khoản.
Xem thêm cách dùng Hugging Face nếu chưa quen model card và files.
Sử dụng Ollama hoặc llama.cpp để chạy cục bộ
Ollama gom việc tải xuống và phục vụ local trong một giao diện. Nó vẫn cần internet để tải ban đầu và đúng tag kiến trúc được hỗ trợ.
- Tải và cài Ollama từ ollama.com (Windows, macOS, Linux).
- Mở terminal và chạy ollama run gemma4. Muốn chọn kích thước, thêm tag như gemma4: e2b, gemma4:12b hoặc gemma4:31b (xem trang gemma4 trên Ollama).
- Ollama tự tải trọng số, phân bổ bộ nhớ và mở API cục bộ tại http://localhost:11434.
- Trang gemma4 của Ollama có sẵn lệnh nối model với agent, ví dụ ollama launch openclaw --model gemma4 hoặc ollama launch hermes --model gemma4.
Sau đó có thể nối local API với agent nếu client hỗ trợ. Suy luận local không tự bảo vệ tool: cần kiểm soát quyền và không mở server ra Internet không xác thực.
Với llama.cpp, chọn GGUF và thiết lập offload/context phù hợp:
- Tải file GGUF của Gemma 4 từ Hugging Face, ví dụ repo google/gemma-4-12B-it-qat-q4_0-gguf do Google phát hành.
- Chạy bằng llama.cpp với số lớp đưa lên GPU phù hợp bộ nhớ máy; Unsloth cũng có bản lượng tử hoá và công cụ tinh chỉnh.
- Llama.cpp hợp khi cần tối ưu sâu tốc độ hoặc chạy trên phần cứng mà Ollama chưa hỗ trợ sẵn.
Gọi Gemma 4 qua Gemini API
Nếu dùng Gemma 4 qua Gemini API, xác nhận model ID và quota trong tài liệu giá. Quyền hosted có thể khác weights; dữ liệu Free và Paid có điều kiện khác, không tự đồng nhất self-host với API.
- Tạo API key trong Google AI Studio, xem cách lấy API key Google Gemini.
- Gọi model qua REST hoặc SDK chính thức cho Python và JavaScript; AI Studio có giao diện thử prompt ngay trên trình duyệt.
- Không dán API key vào mã chạy trên trình duyệt, ứng dụng di động hay repo công khai; đặt key trong biến môi trường hoặc kho bí mật phía máy chủ.
- Nghi lộ key thì thu hồi và tạo key mới ngay (xoay vòng key), rồi kiểm tra lịch sử sử dụng.
Hosted API hợp để thử khi chưa đầu tư GPU. Với nhu cầu giữ dữ liệu riêng hoặc tải lớn, so thêm self-host và provider khác theo điều kiện thực tế.
Hiệu năng của Gemma 4 theo benchmark
Benchmark của Google phải đọc kèm version, precision, reasoning và bộ đề. Không ghép điểm ở model card thành bảng xếp hạng hiện hành với các model khác điều kiện.
Thành tích trên Arena AI
Arena là phép so ưu tiên trả lời của người dùng, khác bộ test toán/coding và có sai số. Một điểm cao ở đó không bảo đảm chất lượng mọi lĩnh vực.
Nếu cần thứ hạng hiện tại, xem nguồn đo trực tiếp và ngày truy cập. Bài không lấy thứ hạng ra mắt 4/2026 làm kết luận.
Điểm chuẩn lập trình và toán học
Các điểm AIME, GPQA, Codeforces hoặc Live Code Bench trong card là tín hiệu tham khảo. Để quyết định deploy, dùng repo, bộ toán hoặc nguồn tài liệu của bạn và chạy cùng cấu hình.
So với các model mở khác
- Không suy benchmark Gemma thành thắng thua với Qwen/Llama khi khác điều kiện.
- Gemma 4 Apache-2.0khác Llama 4 Community License; Qwen license cũng theo checkpoint.
- Nhánh chuyên biệt mới không tự thay thế model ngôn ngữ tổng quát.
Khi chọn model mở, hãy so quyền, tài nguyên, latency và tỷ lệ hoàn thành. Model nhỏ hơn có thể phù hợp hơn nếu tải và budget hạn chế.
Ứng dụng thực tế của Gemma 4
Có thể dùng Gemma cho trợ lý mã, tài liệu hoặc workflow nội bộ. Lợi ích giữ dữ liệu trong hệ thống chỉ đạt nếu mọi thành phần liên quan được cấu hình đúng.
Trợ lý lập trình vận hành hoàn toàn ngoại tuyến
Nối local model với editor qua extension hỗ trợ API cục bộ, rồi đo chất lượng diff và test. Điểm benchmark lập trình không tự bảo đảm mã an toàn hay đúng.
Khi nguồn được xử lý local có thể giảm chuyển ra ngoài, nhưng extension, telemetry, search hay tool vẫn có thể gửi dữ liệu. Rà toàn bộ pipeline.
Agent tự động hoá cho doanh nghiệp
Tool calling và JSON giúp phần mềm agent nhận yêu cầu có cấu trúc; model không tự thực thi API. Cần phân quyền và review hành động trong workflow agent.
Nhiệm vụ có thể là phân loại, trích xuất hoặc nháp tổng hợp báo cáo. Chọn26B-A4B theo kiểm thử thực tế, tính đủ weights/cache thay vì suy tốc độ từ active.
Chatbot đa ngôn ngữ, có tiếng Việt
Khả năng đa ngôn ngữ và tokenizer không tự bảo đảm tiếng Việt chuyên ngành. Dùng đúng bộ đếm token và thử nguồn thật khi ước tính chi phí.
Chatbot nội bộ cần dữ liệu chất lượng, phân quyền tài liệu và cơ chế kiểm chứng. Self-host loại phí API theo token, nhưng tăng chi phí compute/vận hành.
Kết luận
Gemma 4 có nhiều kích thước và Apache-2.0 để đánh giá tự host. Chọn model theo tài nguyên và test thật, không chỉ theo nhãn“chạy được điện thoại”.
Câu hỏi thường gặp
Gemma là gì?
Gemma là họ checkpoint của Google, khác dịch vụ Gemini. Các nhánh Gemma 4, EmbeddingGemma, ShieldGemma hoặc DiffusionGemma có mục đích và model card riêng.
Sử dụng Gemma 4 có mất phí không?
Weights Gemma 4 có Apache-2.0 ở bản đã kiểm tra, nhưng compute/API có chi phí hoặc quota riêng. Download không thu phí không đồng nghĩa toàn bộ triển khai miễn phí.
Gemma 4 có hỗ trợ tiếng Việt không?
Có thể trả lời tiếng Việt; chất lượng cần test từng bản với thuật ngữ và văn phong của bạn. Đánh giá ngôn ngữ không chỉ dựa vào số lượng ngôn ngữ được huấn luyện.
Xem thêm cụm bài về model AI và các lựa chọn API để chọn cách sử dụng phù hợp.