NVIDIA Nemotron là gì? Nemotron 3.5, model agent và cách dùng
Phân biệt các nhánh Nemotron, weights và API, đọc license đúng checkpoint và chọn cách triển khai theo tài nguyên.
Nemotron là họ model và tài nguyên AI của NVIDIA, không phải một chatbot hoặc một checkpoint duy nhất., các nhánh Nemotron 3/3.5 cùng model phụ trợ và checkpoint nghiên cứu phục vụ những mục đích khác nhau. Mức mở dữ liệu, recipe và license cần kiểm tra theo từng bản.
Bạn có thể xem cách so model, API NVIDIA hoặc triển khai local để chọn hướng tiếp cận.
Tổng quan về NVIDIA Nemotron
Danh mục gồm model ngôn ngữ/reasoning, đa phương thức, embedding, rerank, speech và safety. Chúng có thể phối hợp trong hệ thống agent, nhưng một model ngôn ngữ không tự bao gồm toàn bộ chức năng của các nhánh kia.
NVIDIA Nemotron là gì?
NVIDIA phát triển Nemotron để hỗ trợ suy luận, công cụ và các workload AI. Checkpoint open-weight cho phép triển khai trong điều kiện license; agent hoàn chỉnh còn cần phần mềm điều phối, quyền truy cập dữ liệu và kiểm soát hành động.
Một số bản đi cùng dữ liệu, tài liệu và recipe giúp nghiên cứu hoặc tùy chỉnh. Không nên kết luận mọi Nemotron đều công bố cùng mức chi tiết hay đều dùng một giấy phép. Kiểm tra bản gốc và các thành phần kế thừa từ model nền.
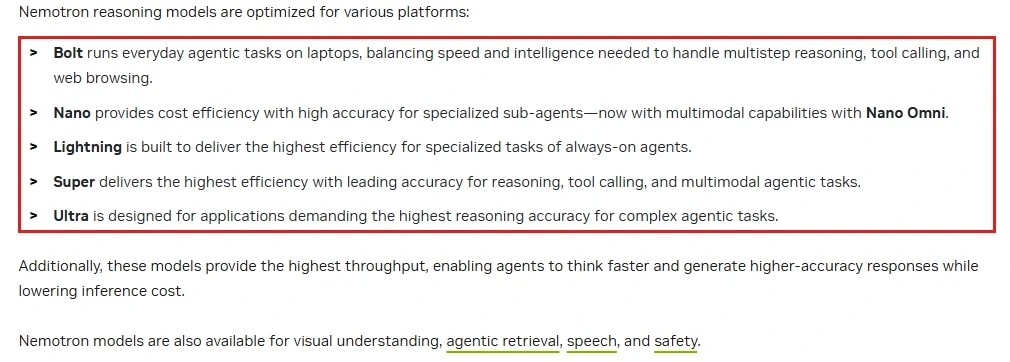
Các tên Bolt, Nano, Lightning, Super và Ultra gợi nhóm triển khai khác nhau. Chọn theo model card, benchmark và tài nguyên thực tế, không chỉ suy từ tên marketing.
Lịch sử ra đời và phát triển của NVIDIA Nemotron
Nemotron có các nhánh kế thừa Llama trước dòng Nemotron 3 riêng. Timeline và ngày tạo kho là dữ kiện lịch sử, không chứng minh một checkpoint cũ đã trở thành bản 3.5.
Nemotron 3 có Nano/Super/Ultra và nhánh Omni;3.5 bổ sung Lightning, Bolt, SuperVL cùng model phụ trợ. Kho NVIDIA còn có Nemotron Labs Sigma nghiên cứu tháng 11; không xem một checkpoint nghiên cứu mới hơn là bản thay thế toàn bộ danh mục production.
Vì sao NVIDIA phát triển Nemotron?
Hệ thống agent cần nhiều hơn GPU: model, dữ liệu, inference engine, quan sát và bảo vệ dữ liệu đều ảnh hưởng kết quả.
Một workflow dài có thể nhiều lần đọc lịch sử, gọi công cụ và sửa kết quả, vì vậy số token và độ trễ tăng. Tối ưu phải đo chi phí toàn tác vụ, không chỉ token/giây của một request ngắn.
NVIDIA nhấn mạnh hiệu quả suy luận và triển khai trên nền tảng tương thích. Tài nguyên, precision, context và concurrency cần được tính cùng chất lượng đầu ra.
Công nghệ cốt lõi đằng sau NVIDIA Nemotron
Kiến trúc lai Mamba – Transformer MoE
Một số Nemotron 3 sử dụng kiến trúc lai Mamba–attention cùng MoE. Nó thay đổi lượng tính toán và bộ nhớ so với Transformer dense; không áp cấu trúc này cho mọi checkpoint mang thương hiệu Nemotron.
Ví dụ Ultra có tên 550B-A55B để phân biệt tổng tham số và active. Bộ nhớ chạy model không chỉ cần chứa 55B active mà còn phải đáp ứng weights, cache và engine.
Công nghệ Latent MoE
Latent MoE xử lý trong không gian latent để cải thiện trade-off tài nguyên và chất lượng theo thiết kế của model. Đây không phải lời hứa cùng phần cứng luôn đạt tốc độ hoặc độ chính xác cao hơn ở mọi tác vụ.
Multi-Token Prediction (MTP)
Multi-token prediction/speculative decoding có thể tăng tốc khi engine hỗ trợ. Các bản NVFP4/BF16/FP8 khác định dạng và yêu cầu phần cứng; phải dùng recipe đúng, không đổi đuôi tên model rồi kỳ vọng lệnh cũ vẫn chạy.
Các phiên bản Nemotron 3 và Nemotron 3.5
Bảng dưới phân biệt một số nhánh tiêu biểu. Để tìm bản mới và precision, mở tổ chức NVIDIA và danh mục Nemotron, không dùng một bảng như danh sách bất biến.
| Nhánh | Vai trò tham khảo | Điểm cần xác minh |
|---|---|---|
| Nemotron 3 Nano/Super/Ultra | Ngôn ngữ, reasoning, agent | Quy mô, precision, license riêng |
| Nano Omni | Hiểu nhiều dạng dữ liệu | Processor, input và engine |
| 3.5Super VL 120B-A12B | Vision và reasoning | Weights OpenMDW 1.1 |
| 3.5 Bolt E4B | Nhóm model nhỏ/local | OpenMDW 1.1, VRAM/RAM và precision |
| Embed/Rerank/Speech/Safety | Thành phần pipeline | Schema và license đúng nhánh |
| Nemotron Labs Sigma | Checkpoint nghiên cứu | Không coi là thay thế mọi model production |
Nemotron 3 Nano
Nano là nhóm cần tài nguyên thấp hơn các bản Super/Ultra trong cùng dòng. Khả năng reasoning và budget phải theo card/endpoint được chọn.
Nemotron 3 Nano Omni
Nano Omni hướng tới nhiều phương thức dữ liệu, gồm ảnh, âm thanh và video theo card. Đầu vào hỗ trợ không có nghĩa model tự sinh mọi loại đầu ra media.
Nemotron 3 Super
Nemotron 3 Super 120B-A12B phục vụ workload cần chất lượng và tài nguyên cân bằng hơn Ultra. Context dài vẫn đòi hỏi thêm cache và thời gian xử lý; đọc recipe triển khai thay vì chỉ số trên tên.
Nemotron 3 Ultra
Ultra 550B-A55B là bản lớn trong dòng 3. Card chính chủ công bố weights dưới OpenMDW 1.1. Lựa chọn này hướng tới hạ tầng lớn hoặc API, không phải mặc định cho laptop.
Nemotron 3.5
Trong dòng 3.5, SuperVL thêm vision, Bolt hướng tới các cấu hình local và Lightning phục vụ agent. Super VL 120B-A12B và Bolt E4B được card ghi license OpenMDW 1.1. Không tự coi chúng là Apache-2.0.
Đối chiếu quyền và kiến trúc với các model mở trọng số.
Nemotron đa phương thức, speech, RAG và safety
Một pipeline RAG có thể dùng Embed/Rerank bên cạnh LLM, còn speech/safety dùng model khác. Chọn từng thành phần theo tác vụ, license và schema thay vì tìm một endpoint làm mọi việc.
Model đa phương thức có thể giảm số bước ghép perception, nhưng processor và engine vẫn cần hỗ trợ đúng input. Với computer use, phần mềm bên ngoài thực thi hành động và phải quản lý quyền.
Điểm khác biệt của NVIDIA Nemotron so với các mô hình AI khác
Mức mở có ý nghĩa khi tài liệu, weights và tài nguyên phát hành đủ để kiểm tra/tùy chỉnh. Hãy ghi chính xác những gì checkpoint có, không suy ra dữ liệu huấn luyện đầy đủ chỉ từ chữ open.
Có thể dùng nhiều model trong một hệ thống: model nhỏ làm phân loại hoặc bước đơn giản, model khác xử lý việc khó. Hiệu quả phải đo cả routing, số lần gọi và khả năng lỗi lan giữa các bước.
Nên đọc benchmark của Nemotron thế nào?
So chất lượng, tốc độ, bộ nhớ và chi phí hoàn thành cùng nhiệm vụ. Benchmark trên GPU NVIDIA với engine tối ưu không tự tương đương kết quả trên CPU hoặc phần cứng khác.
- Điểm chất lượng tổng hợp và tốc độ đo độc lập: xem các bảng xếp hạng như Artificial Analysis, ghi rõ ngày xem vì thứ hạng đổi theo từng đợt model mới.
- Số liệu thông lượng do NVIDIA công bố đo trên GPU của NVIDIA với cấu hình cụ thể; trên phần cứng khác kết quả sẽ khác.
- Bảng so sánh nhiều model theo benchmark có nguồn, ngày có ở bài so sánh các AI model theo benchmark.
Ưu điểm và hạn chế của NVIDIA Nemotron
Lợi ích có thể là quyền tự vận hành, recipe và các nhánh phụ trợ. Hạn chế là tài nguyên ở bản lớn, mức hỗ trợ engine và license khác theo checkpoint.
Ưu điểm
- Mở trọng số, dữ liệu huấn luyện và công thức, có báo cáo kỹ thuật (NVIDIA).
- Tối ưu thông lượng trên GPU NVIDIA, chạy được bằng vLLM, SGLang, Ollama, llama.cpp hoặc NVIDIA NIM.
- Họ model đủ mảng: văn bản, thị giác, giọng nói, nhúng và rerank cho RAG, lọc an toàn nội dung.
- Tự triển khai được trên hạ tầng riêng khi cần giữ dữ liệu trong nước.
Hạn chế
- Tùy bảng xếp hạng, điểm suy luận thuần của Nemotron có thể thấp hơn một số model open-weight lớn khác; hãy so ở thời điểm bạn chọn.
- Super, Ultra và Super VL cần GPU trung tâm dữ liệu; máy chỉ có CPU chỉ hợp với bản rất nhỏ và chạy chậm.
- Giấy phép NVIDIA Open Model License và OpenMDW-1.1 có điều khoản riêng, cần đọc trước khi dùng thương mại.
- Hiệu năng công bố đo trên GPU NVIDIA; trên phần cứng khác có thể khác nhiều.
Ứng dụng thực tế của NVIDIA Nemotron trong doanh nghiệp
Trong doanh nghiệp, model có thể tham gia truy hồi, phân loại, trợ lý và workflow công cụ. Đặt mục tiêu chất lượng, nguồn dữ liệu và quyền hành động trước khi chọn nhánh Nemotron.
Ví dụ: ghép embedding/rerank cho tìm tài liệu, coding model cho review, Omni cho audio/video hoặc safety model để bổ sung kiểm soát nội dung. Mỗi thành phần cần đánh giá riêng.
Hướng dẫn trải nghiệm NVIDIA Nemotron mới nhất
Có thể tải weights, thử hosted endpoint NVIDIA hoặc gọi provider khác. Self-host tăng quyền kiểm soát nhưng đòi vận hành; hosted không cần GPU ở phía client nhưng có quota và điều khoản dữ liệu.
Qua Hugging Face
Vào kho NVIDIA chính chủ, chọn đúng card và đọc LICENSE, precision, processor và recipe. Dùng engine/version được card hướng dẫn; một lệnh transformers chung không chắc hỗ trợ mọi kiến trúc mới.
Với máy cá nhân, bắt đầu từ bản nhỏ đã được engine hỗ trợ và tính đủ RAM/VRAM/context. Bản quant cộng đồng cần kiểm tra nguồn và mức suy giảm chất lượng. CPU có thể chạy một số cấu hình nhưng tốc độ không được bảo đảm.
Qua build.nvidia.com (NIM Microservice)
NIM là công nghệ đóng gói inference, còn API Catalog là nơi thử hosted endpoints. Tự triển khai container và gọi API thử của NVIDIA là hai hình thức vận hành/điều khoản khác nhau.
Thực hành ở hướng dẫn key NVIDIA.
Qua các nền tảng đối tác
Nếu dùng provider, xác nhận đúng ID, version, giá, quota và chính sách dữ liệu. Giữ key ở backend, tách theo ứng dụng và theo dõi Usage; xem bảo vệ credentials.
Xem cấu hình OpenRouter nếu model được provider hỗ trợ.
Kết luận
Nemotron là tập hợp lựa chọn cho nhiều workload, không phải một model luôn tốt nhất. Bản 3.5, model phụ trợ và nghiên cứu mới cần được chọn theo mục tiêu cụ thể.
Thử một endpoint hoặc checkpoint vừa tài nguyên, đo tác vụ thực tế rồi mới quyết định đầu tư self-host lớn.
Câu hỏi thường gặp
NVIDIA Nemotron có miễn phí không?
Weights có thể được tải trong quyền license, nhưng compute và dịch vụ hosted không tự miễn phí. NVIDIA API Catalog có điều kiện phát triển/trial riêng; đọc card và điều khoản trước khi dùng.
Phiên bản Nemotron nào hợp với doanh nghiệp vừa và nhỏ?
Không thể chọn theo quy mô doanh nghiệp đơn thuần. Tính workload, độ trễ, dữ liệu và budget; có thể API của model lớn hợp hơn tự host model nhỏ, hoặc ngược lại.
NVIDIA Nemotron có hỗ trợ tiếng Việt không?
Có thể có khả năng đa ngôn ngữ nhưng cần thử tiếng Việt theo lĩnh vực. Một điểm benchmark chung không bảo đảm văn phong, thuật ngữ hoặc độ đúng của dữ liệu Việt.
Có thể chạy NVIDIA Nemotron trên máy tính cá nhân không?
Có thể với một số bản nhỏ/quant được engine hỗ trợ; kiểm tra model cụ thể và tài nguyên. Super/Ultra thường cần hạ tầng lớn hoặc API.
NVIDIA Nemotron có xử lý hình ảnh và giọng nói không?
Có các nhánh phù hợp cho từng dạng dữ liệu, như Omni, SuperVL và Transcribe. Phải phân biệt hiểu âm thanh với tạo âm thanh và chọn đúng processor/endpoint.
Xem thêm cụm bài về model AI và các lựa chọn API để chọn cách sử dụng phù hợp.