Transformer LLM: attention, ngữ cảnh và vai trò trong AI agent
Hiểu kiến trúc Transformer, giới hạn của self-attention và cách LLM phối hợp công cụ để giải quyết công việc.
Transformer LLM là model ngôn ngữ lớn sử dụng kiến trúc Transformer hoặc một biến thể dựa trên attention. Nó biểu diễn quan hệ giữa token để học và sinh ngôn ngữ. Với model sinh tự hồi quy, đầu ra được tạo từng token dựa trên phần ngữ cảnh đã có; attention không có nghĩa model biết trước mọi token tương lai.
Tổng quan về Transformer LLM
Transformer là tên kiến trúc, còn LLM mô tả một lớp model ngôn ngữ quy mô lớn. Nhiều hệ thống hội thoại và trợ lý code được xây trên nền tảng này, nhưng một sản phẩm hoàn chỉnh còn có dữ liệu, công cụ, chính sách và môi trường vận hành quanh model.
Transformer LLM là gì?
Một LLM được huấn luyện để học các quy luật thống kê từ dữ liệu. Khi dùng Transformer, mạng kết hợp attention với các thành phần khác để biến biểu diễn token thành dự đoán. Khả năng tạo văn bản trôi chảy không bảo đảm nội dung luôn đúng hoặc phản ánh hiểu biết như con người.
Có thể hình dung model học rất nhiều mẫu từ dữ liệu rồi dự đoán phần tiếp theo dựa trên prompt. Tuy nhiên đó chỉ là ví dụ để dễ hiểu: nó không phải người đọc sách, không nhớ nguyên vẹn mọi trang và không tự xác minh từng phát biểu.
Tham khảo cách đọc benchmark model nếu muốn nối khái niệm kiến trúc với phép đo năng lực thực tế.
Lịch sử ra đời của Transformer LLM
Bài báo Attention Is All You Need công bố năm 2017 mô tả Transformer cho bài toán sequence-to-sequence, với thử nghiệm dịch máy. Điểm mới quan trọng là dựa vào attention thay vì cơ chế hồi quy/convolution làm trục chính của kiến trúc gốc.
RNN và LSTM thường truyền trạng thái theo chuỗi, gây khó khăn cho song song hóa huấn luyện và học liên hệ xa. Transformer cho nhiều vị trí tham gia tính toán song song khi huấn luyện và tạo đường attention trực tiếp hơn; quá trình sinh tự hồi quy vẫn lần lượt tạo token.
Các nhánh phát triển sau đó gồm encoder như BERT, decoder tự hồi quy và encoder–decoder. Chúng có cách huấn luyện và tác vụ khác nhau, nên không thể lấy mô tả một chatbot để áp cho mọi Transformer.
Cơ chế hoạt động của Transformer LLM
Cơ chế tự chú ý (Self-Attention)
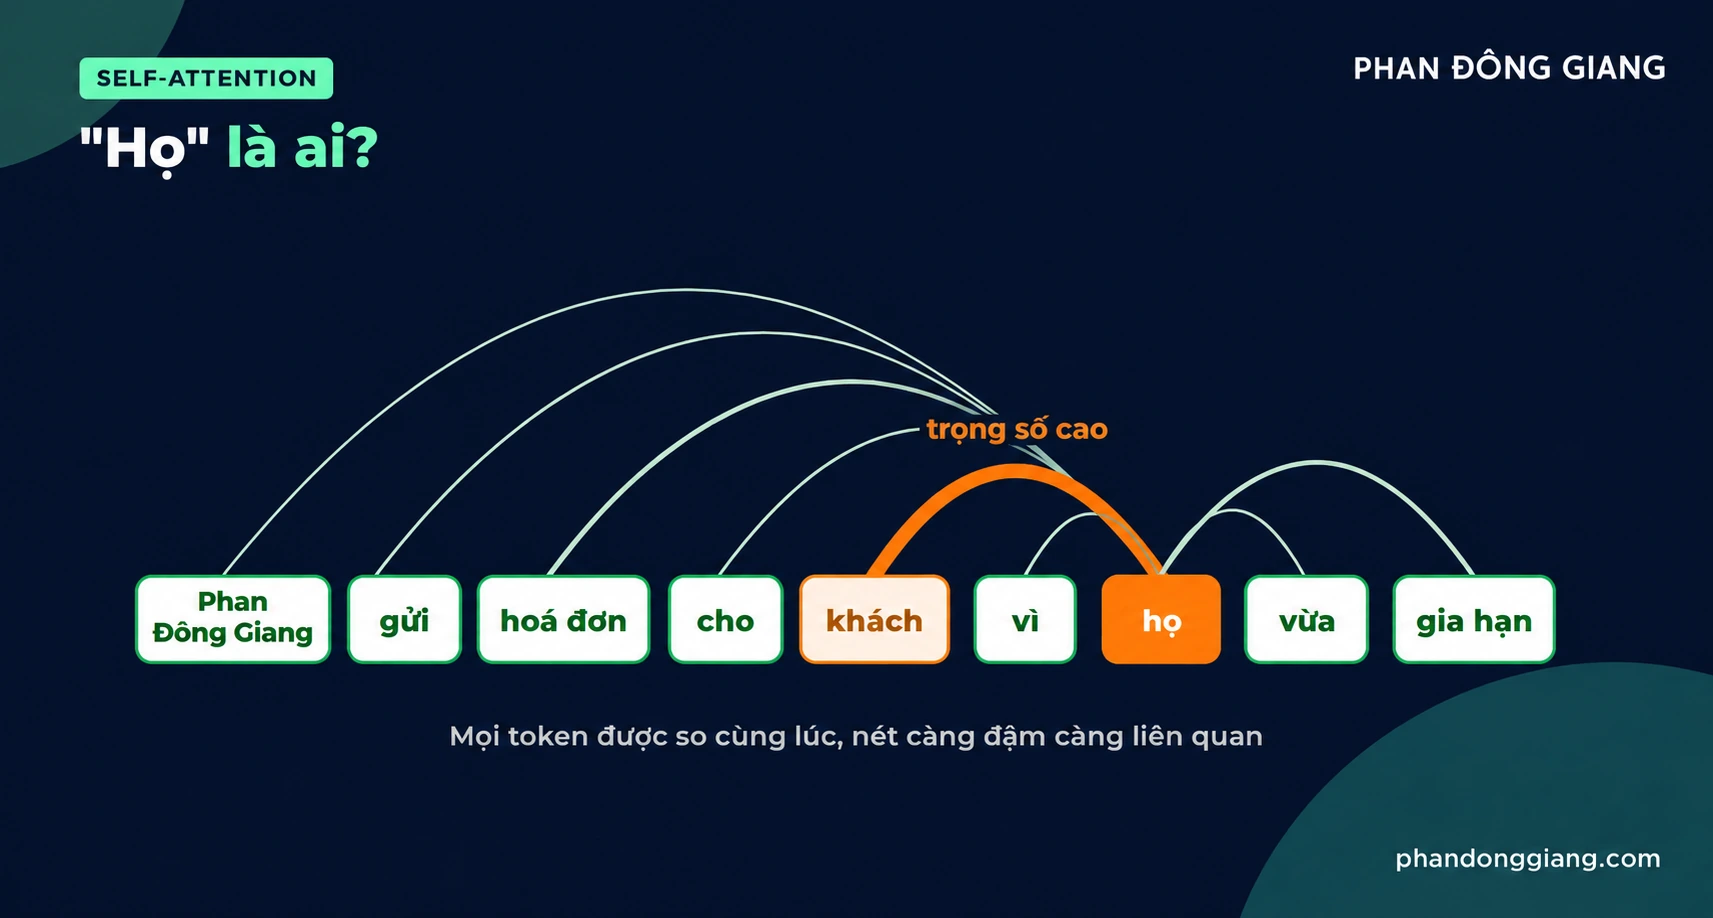
Self-attention dùng biểu diễn query, key và value để kết hợp thông tin giữa các vị trí theo mask cho phép. Chẳng hạn model có thể học quan hệ giữa một đại từ và danh từ liên quan ở xa, nhưng ví dụ ngôn ngữ đơn giản không chứng minh một attention head mang ý nghĩa cố định.
Sơ đồ là minh họa khái niệm, không phải attention map đo từ một model cụ thể. Multi-head attention thực hiện nhiều phép chiếu song song; diễn giải từng head là một “chuyên gia ngữ pháp” luôn đúng sẽ quá đơn giản hóa.
Mã hóa vị trí (Positional Encoding)
Attention cần thông tin về vị trí hoặc thứ tự để phân biệt các chuỗi có cùng token nhưng nghĩa khác nhau. Kiến trúc gốc dùng positional encoding; các model sau có thể dùng những phương pháp vị trí khác như rotary embeddings.
Kiến trúc Encoder – Decoder
Transformer gốc có encoder đọc nguồn và decoder sinh đích. BERT thiên về encoder, còn nhiều model sinh văn bản dùng decoder-only với causal mask, chỉ dựa vào các token được phép thấy ở phía trước. Feed-forward, normalization và residual connection cũng là phần quan trọng, không chỉ attention.
Vì sao Transformer LLM thay thế các mô hình cũ?
Kiến trúc này thuận lợi cho huấn luyện trên phần cứng song song và học quan hệ xa. Đổi lại, context, bộ nhớ và chi phí suy luận cần được quản lý; attention không loại bỏ hallucination hay giới hạn dữ liệu.
Lợi thế của Transformer LLM
Có thể tóm tắt ba lợi ích so với kiến trúc tuần tự truyền thống:
- Huấn luyện song song: xử lý nhiều vị trí trong một batch thay vì phụ thuộc hoàn toàn vào trạng thái trước.
- Liên hệ xa: attention có thể kết hợp thông tin ở nhiều vị trí trong context được phép.
- Khả năng thích ứng: cùng họ kiến trúc có thể dùng cho hiểu ngôn ngữ, sinh văn bản, code và nhiều modality sau khi thiết kế/huấn luyện phù hợp.
Hạn chế của Transformer LLM
Với full attention chuẩn, phần tính toán theo cặp vị trí tăng bậc hai theo độ dài chuỗi, dù các biến thể và kernel tối ưu có thể thay đổi mức dùng thực tế. Model vẫn có thể tạo thông tin sai và kiến thức từ trọng số có giới hạn thời điểm; một sản phẩm có công cụ tra cứu là lớp bổ sung.
Với số liệu, tính toán hoặc thông tin mới, kết hợp công cụ đáng tin và kiểm tra kết quả. RAG cung cấp tài liệu liên quan nhưng không tự bảo đảm câu trả lời đúng; vẫn cần đối chiếu nguồn và giới hạn quyền khi tác vụ quan trọng.
Transformer LLM liên quan gì đến AI Agent?
Trong agent, LLM thường đọc yêu cầu, context và mô tả tool để đề xuất hành động tiếp theo. Hệ thống bao quanh model thực hiện tool, lưu trạng thái, kiểm quyền và đưa kết quả về vòng lặp.
Ví dụ một yêu cầu tìm khách hàng rồi soạn email cần bước truy xuất, phân loại, viết và kiểm tra. Model hỗ trợ diễn giải mục tiêu và tạo nội dung, còn việc truy cập CRM hay gửi thư phụ thuộc tool được cấp; soạn thư không đồng nghĩa đã được phép gửi.
Để thành agent vận hành được, cần công cụ, bộ nhớ, xử lý lỗi, kiểm soát truy cập và quan sát hoạt động. MCP là một cách chuẩn hóa kết nối công cụ, không phải phép biến model thành một tác nhân luôn đúng hoặc có toàn quyền.
Các mô hình Transformer LLM nổi bật hiện nay
Catalog đã có các thế hệ mới như GPT-6.2 Astra/Sol, Claude Fable 5.2 và nhóm Gemini 4. Tuy nhiên nhà cung cấp đóng thường không công bố đầy đủ kiến trúc; không khẳng định mọi chi tiết model hiện hành giống Transformer 2017 chỉ từ tên sản phẩm.
- OpenAI: xem catalog model và bài model OpenAI để chọn ID/quyền truy cập hiện hành.
- Anthropic: model overview tách phiên bản Claude, tính năng và vòng đời; đọc thêm model Claude.
- Google: Gemini API models là nguồn cho ID, modality và trạng thái; xem model Gemini.
- Model công khai trọng số: các họ Qwen, DeepSeek, Gemma, Laguna và nhiều dòng khác có kiến trúc/giấy phép riêng. Xem LLM mở và chạy local, không đồng nhất open-weight với toàn bộ dữ liệu/mã đều mở.
Ứng dụng thực tế của Transformer LLM trong đời sống
Ứng dụng thường nằm ở đọc, viết và biến đổi thông tin: tóm tắt, dịch, hỗ trợ code hoặc hỏi đáp dựa trên tài liệu. Những lĩnh vực có hậu quả lớn cần quy trình xác minh phù hợp, không dùng văn phong tự tin làm bằng chứng.
- Văn phòng: chuẩn bị email, tóm tắt và dịch với bước kiểm tra nội dung.
- Học tập: giải thích khái niệm, tạo ví dụ và bài tập có đối chiếu.
- Tài liệu chuyên ngành: hỗ trợ tìm và tổng hợp, không thay thẩm định chuyên môn.
- Phần mềm: sinh code, giải thích và đề xuất sửa với test.
- Phân loại: các model được huấn luyện phù hợp có thể hỗ trợ lọc nội dung hoặc nhận diện rủi ro, nhưng không phải lá chắn tuyệt đối.
Cách khai thác Transformer LLM hiệu quả hơn
Bạn có thể bắt đầu sử dụng mà chưa cần thuộc công thức. Chất lượng công việc thường cải thiện khi mục tiêu rõ, context đúng và đầu ra có tiêu chí kiểm; hiểu giới hạn giúp chọn lúc cần tool thay vì cố kéo mọi việc vào prompt.
- Nêu mục tiêu: chỉ rõ đối tượng, đầu ra và tiêu chí chấp nhận.
- Cung cấp context liên quan: đưa dữ liệu cần thiết thay vì đổ mọi tài liệu vào một cửa sổ dài.
- Chọn mức giải thích: yêu cầu ví dụ và độ sâu phù hợp người đọc.
- Đối chiếu: kiểm thông tin mới, số liệu và chi tiết kỹ thuật bằng nguồn đáng tin.
- Dùng retrieval/tool: lấy dữ liệu hoặc tính toán từ hệ thống phù hợp, rồi kiểm cách model sử dụng kết quả.
Xu hướng phát triển Transformer LLM
Các hướng phát triển bao gồm hiệu quả suy luận, context, nhiều modality, khả năng dùng tool và model chuyên biệt. Đây là nhiều nhánh nghiên cứu/triển khai, không phải một lộ trình bắt buộc mà mọi model đều đi qua.
- Context dài: tăng lượng dữ liệu có thể đưa vào, đồng thời cần đo truy hồi và chi phí.
- Đa phương thức: phối hợp text, ảnh, audio hoặc video theo thiết kế model.
- MoE: định tuyến một phần tính toán qua expert, với đánh đổi riêng về bộ nhớ/hệ thống.
- RAG: đưa tài liệu bên ngoài vào luồng trả lời.
- Agent: kết hợp model với trạng thái, công cụ và chính sách.
- Inference tối ưu: quantization, caching, batching và kernel giúp phục vụ hiệu quả.
- Model nhỏ chuyên tác vụ: có thể phù hợp thiết bị biên hoặc workload hẹp nếu được đánh giá đúng.
Transformer giải thích một phần cách model biểu diễn và xử lý chuỗi; ứng dụng tốt còn cần dữ liệu, đánh giá và thiết kế hệ thống. Muốn học tiếp từ nền tảng tới agent, đọc lộ trình LLM và AI agent.
Câu hỏi thường gặp
Transformer và LLM khác nhau thế nào?
Transformer là kiến trúc; LLM là lớp model ngôn ngữ đã được huấn luyện ở quy mô lớn. Có Transformer cho ảnh hoặc tác vụ nhỏ, và có LLM dùng thiết kế lai với thành phần khác.
Ai là người phát minh ra Transformer?
Bài báo 2017 có nhóm nghiên cứu gồm tám người: Ashish Vaswani, Noam Shazeer, Niki Parmar, Jakob Uszkoreit, Llion Jones, Aidan N. Gomez, Łukasz Kaiser và Illia Polosukhin. Khi cần trích nguồn lịch sử, dùng bài báo gốc.
Doanh nghiệp nên ứng dụng Transformer LLM ra sao?
Chọn một tác vụ có dữ liệu, giá trị và tiêu chí rõ; xây đánh giá trước khi mở rộng. Hỏi đáp tài liệu cần retrieval/phân quyền; tự động hóa cần kiểm soát tool và điểm xác nhận của người khi phù hợp.
Có những mô hình thay thế Transformer trong tương lai không?
Các hướng như Mamba và kiến trúc lai tìm cách cải thiện hiệu quả chuỗi dài. Sự tồn tại của chúng không có nghĩa attention đã bị thay thế hoàn toàn; cần đọc kiến trúc từng model.
Học về Transformer LLM cần kiến thức nền gì?
Bắt đầu từ token, embedding, mạng nơ-ron và attention bằng ví dụ. Khi muốn nghiên cứu sâu, bổ sung đại số tuyến tính, xác suất, tối ưu và thực hành huấn luyện/đánh giá ở quy mô phù hợp.