Các model Llama: lịch sử phiên bản, kích thước và cách chọn
Phân biệt Llama 2, Llama 3 và Llama 4 Scout/Maverick; so sánh ngữ cảnh, bộ nhớ, giấy phép và lựa chọn theo từng nhu cầu.
các trọng số Llama tổng quát mới nhất được xác minh trên tài khoản Meta vẫn là Llama 4 Scout và Maverick. Chưa có Llama 5 được xác nhận trong danh mục này. Các đời trước gồm LLaMA 1, Llama 2, Code Llama và Llama 3 với các bản 3.1, 3.2, 3.3.
Bài viết này tập trung vào lịch sử, kích thước và lựa chọn model. Phần sử dụng, tải weights và triển khai từng bước nằm ở Llama của Meta là gì. Nếu muốn thử qua dịch vụ mà chưa tự host, xem các hình thức LLM API miễn phí.
Tổng quan về hệ sinh thái Llama và định hướng phát triển của Meta
Llama gồm model nền, bản tuân theo chỉ dẫn và các model chuyên dụng do Meta công bố trọng số. Người triển khai có thể tải, tinh chỉnh và phục vụ trên hạ tầng riêng theo giấy phép tương ứng, hoặc dùng dịch vụ của nhà cung cấp khác.
Khi đọc một tên Llama, trước hết cần phân biệt loại checkpoint:
- Base: model nền dùng cho nghiên cứu, tiếp tục huấn luyện hoặc tinh chỉnh.
- Instruct/Chat: checkpoint đã hậu huấn luyện để làm theo chỉ dẫn và hội thoại.
- Chuyên dụng: Code Llama cho mã nguồn, Llama Guard cho phân loại an toàn.
Cách phân phối weights giúp cộng đồng xây sản phẩm và công cụ quanh Llama. Tuy nhiên, “có thể tải xuống” không đồng nghĩa giấy phép nguồn mở không hạn chế: Llama dùng điều khoản cộng đồng cùng chính sách sử dụng riêng.
Đọc phần giới thiệu và hướng dẫn thực hành ở Llama AI là gì.
Triết lý “Open + Efficient + Scalable”
Có thể nhìn định hướng của hệ sinh thái qua ba yếu tố:
- Quyền tiếp cận: có thể tải weights theo giấy phép cộng đồng áp dụng cho từng phiên bản; không gọi chung là giấy phép nguồn mở không hạn chế.
- Hiệu quả triển khai: nhiều kích cỡ nhỏ hỗ trợ thử nghiệm trên thiết bị cá nhân, còn lượng tử hóa giúp giảm phần bộ nhớ weights.
- Khả năng mở rộng: dense, MoE và các mức ngữ cảnh tạo nhiều lựa chọn; tổng tham số và active parameters phản ánh những khía cạnh khác nhau.
Vai trò của Llama trong làn sóng AI mã nguồn mở
Llama góp phần mở rộng khả năng tiếp cận LLM có trọng số công khai. Thuật ngữ chính xác trong bài này là open-weight; quyền sử dụng cần đọc theo từng thế hệ, thay vì gọi chung tất cả là mã nguồn mở.
- Thêm lựa chọn triển khai: người dùng có thể kiểm soát weights và hạ tầng theo license, thay vì chỉ phụ thuộc vào một API.
- Nền tảng tùy chỉnh: checkpoint có sẵn giúp giảm nguồn lực cần để phát triển model cho ngôn ngữ hoặc lĩnh vực riêng.
- Hỗ trợ nghiên cứu: công khai weights cho phép phân tích hành vi, rủi ro và phương pháp cải thiện, dù dữ liệu huấn luyện không nhất thiết được công bố đầy đủ.
Danh sách các model của Llama qua từng giai đoạn
Từ năm 2023, Llama mở rộng từ model văn bản phục vụ nghiên cứu sang cả vision-language và MoE. Mỗi lần thay đổi phiên bản mang theo khác biệt về ngữ cảnh, định dạng hội thoại và khả năng triển khai.
Đối chiếu tài khoản meta-llama, Scout và Maverick vẫn là hai model Llama 4 có weights công khai. Behemoth được giới thiệu ở dạng xem trước, chưa nên xem là lựa chọn triển khai. Các sản phẩm Muse trên trang nhà phát triển Meta thuộc dòng khác; chúng không chứng minh rằng đã có “Llama 5”.
Giai đoạn LLaMA 1 – Đặt nền móng cho hệ sinh thái
LLaMA thế hệ đầu được giới thiệu tháng 2/2023 với bốn kích cỡ:
- LLaMA 7B
- LLaMA 13B
- LLaMA 33B
- LLaMA 65B
Đây là các model dense dành chủ yếu cho nghiên cứu. Cơ chế cấp quyền ban đầu khác với giấy phép cộng đồng thương mại từ Llama 2, vì thế không được áp quyền của đời mới ngược lại cho LLaMA 1.
Thế hệ đầu cho thấy một model có số tham số vừa phải vẫn có thể cạnh tranh trong một số bài đánh giá. Hiện chúng phù hợp hơn với nghiên cứu lịch sử và tái hiện kết quả cũ.
Giai đoạn Llama 2 – Mở rộng sang ứng dụng thương mại
Tháng 7/2023, Llama 2 mở rộng quyền sử dụng sang nghiên cứu và thương mại theo Community License. Đây là thay đổi về điều kiện phân phối và sử dụng, không phải chuyển sang Apache-2.0.
Ba quy mô chủ yếu gồm:
- Llama 2 7B
- Llama 2 13B
- Llama 2 70B
Mỗi quy mô có bản nền để tinh chỉnh và bản Chat hướng tới hội thoại. Llama 2 dùng ngữ cảnh 4.096 token, dài gấp đôi mức 2.048 token của LLaMA đầu tiên.
Code Llama – Nhánh chuyên biệt dành cho lập trình
Code Llama được xây trên Llama 2, xuất hiện tháng 8/2023. Danh mục sau đó được bổ sung bản 70B vào tháng 1/2024:
- Code Llama 7B
- Code Llama 13B
- Code Llama 34B
- Code Llama 70B (bổ sung 01/2024)
Ba hướng sử dụng chính được phân tách thành:
- Code Llama: Model nền chuyên xử lý mã nguồn.
- Code Llama – Python: Tối ưu riêng cho ngôn ngữ Python.
- Code Llama – Instruct: Nhận yêu cầu bằng ngôn ngữ tự nhiên để tạo, giải thích hoặc sửa mã nguồn.
Code Llama vẫn hữu ích cho pipeline cũ hoặc tính năng fill-in-the-middle đã tích hợp. Với dự án mới, nên so trực tiếp với các model lập trình hiện hành và Llama mới hơn; đời mới không tự bảo đảm thắng trên mọi ngôn ngữ hoặc tác vụ.
Giai đoạn Llama 3 – Nâng cấp mạnh về dữ liệu và hiệu suất
Llama 3 được công bố tháng 4/2024, bắt đầu bằng hai kích cỡ:
- Llama 3 8B
- Llama 3 70B
Cả hai có bản pretrained và Instruct. Thế hệ này nâng ngữ cảnh lên 8K, đổi tokenizer và tăng đáng kể dữ liệu huấn luyện so với Llama 2.
8B dễ thử trên hạ tầng nhỏ hơn, còn 70B cần nhiều tài nguyên để đổi lấy chất lượng tiềm năng cao hơn. Cả hai vẫn phải được đánh giá trên ngôn ngữ và nhiệm vụ thực tế.
Giai đoạn Llama 3.1 – Xuất hiện model 405B
Đợt phát hành tháng 7/2024 mở rộng Llama 3.1 thành ba quy mô:
- Llama 3.1 8B
- Llama 3.1 70B
- Llama 3.1 405B
Bản 405B đánh dấu quy mô dense lớn trong họ Llama. Llama 3.1 hỗ trợ ngữ cảnh 128K; bản Instruct hướng tới hội thoại đa ngôn ngữ, sử dụng công cụ và lập trình. Bản base không tự có hành vi trợ lý giống Instruct.
Có thể cân nhắc từng kích cỡ theo hướng sau:
- Llama 3.1 8B: Phù hợp chạy local, thử nghiệm và tinh chỉnh với chi phí thấp.
- Llama 3.1 70B: Cân bằng giữa chất lượng và chi phí cho ứng dụng doanh nghiệp.
- Llama 3.1 405B: Hướng đến nghiên cứu, tạo dữ liệu tổng hợp, chưng cất model và các tác vụ chuyên sâu.
Trong các model dense của họ Llama đã kiểm tra, 405B vẫn là quy mô lớn nhất. Llama 4 có tổng tham số lớn nhưng dùng MoE, nên không so số tham số như hai kiến trúc hoàn toàn giống nhau.
Giai đoạn Llama 3.2 – Tập trung vào thiết bị biên và xử lý hình ảnh
Tháng 9/2024, Llama 3.2 tách thành nhóm văn bản nhỏ và nhóm Vision. Đây là hai hướng sử dụng có yêu cầu phần cứng khác nhau.
Model chỉ xử lý văn bản
- Llama 3.2 1B
- Llama 3.2 3B
1B và 3B là model văn bản dành cho triển khai nhỏ, thiết bị biên và máy cá nhân. Chúng có thể hỗ trợ tóm tắt, viết lại, phân loại và công cụ đơn giản; ngữ cảnh 128K vẫn cần bộ nhớ tương ứng khi khai thác gần mức tối đa.
Model xử lý văn bản và hình ảnh
- Llama 3.2 11B Vision
- Llama 3.2 90B Vision
11B Vision và 90B Vision nhận văn bản kèm hình ảnh, tạo đầu ra văn bản. Có thể dùng cho hỏi đáp trên ảnh, đọc biểu đồ, mô tả hoặc trích xuất từ tài liệu trực quan.
Không nên gọi chung toàn bộ Llama 3.2 là model nhỏ. Hai bản Vision mang thành phần và mục đích khác với 1B/3B chỉ xử lý văn bản, đồng thời có điều kiện sử dụng cần kiểm riêng.
Giai đoạn Llama 3.3 – Tối ưu model 70B
Llama 3.3 xuất hiện tháng 12/2024 với một model chính thức:
- Llama 3.3 70B Instruct
Llama 3.3 không cung cấp cả một dãy kích cỡ như 3.1. Bản 70B Instruct là checkpoint văn bản đã hậu huấn luyện theo chỉ dẫn.
Model này hỗ trợ ngữ cảnh 128K. Meta công bố chất lượng cạnh tranh với Llama 3.1 405B trên một số bài đánh giá trong khi nhẹ hơn để phục vụ. Điều đó không có nghĩa ngang nhau ở mọi tác vụ; vẫn cần đo cho RAG, lập trình hoặc dữ liệu doanh nghiệp.
Giai đoạn Llama 4 – Kiến trúc MoE và đa phương thức tự nhiên
Llama 4 được giới thiệu tháng 4/2025 với các thay đổi chủ yếu:
- Chuyển từ kiến trúc Dense sang Mixture of Experts – MoE.
- Xử lý văn bản và hình ảnh ngay từ quá trình huấn luyện.
- Mở rộng mạnh cửa sổ ngữ cảnh.
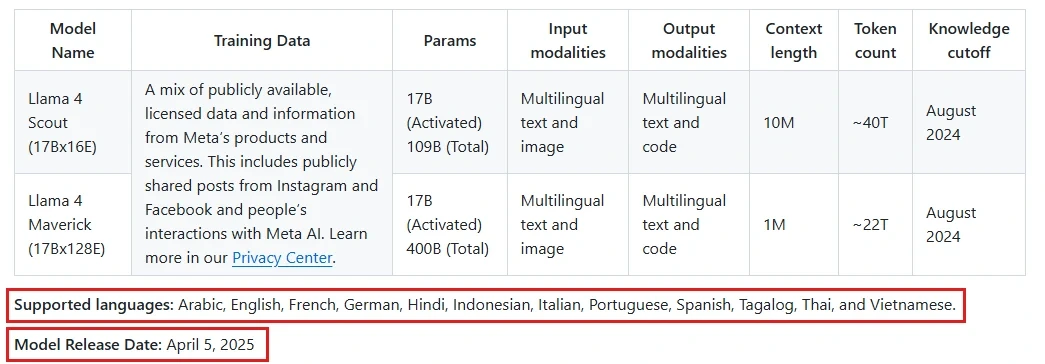
Scout và Maverick là hai bản có trọng số được phát hành. Chúng đều nhận văn bản và ảnh, nhưng có số expert, tổng tham số và ngữ cảnh khác nhau.
Llama 4 Scout
Các thông số công bố của Scout gồm:
- 17B tham số hoạt động
- 109B tổng tham số
- 16 expert
- Cửa sổ ngữ cảnh tối đa 10 triệu token
- Đầu vào gồm văn bản và hình ảnh
- Đầu ra gồm văn bản và mã nguồn
Scout hướng tới tài liệu dài, kho mã và dữ liệu kết hợp ảnh với chữ. Meta nêu khả năng triển khai bản Int4 trên một H100 80GB trong cấu hình phù hợp; đây không phải bảo đảm mọi backend, concurrency hay ngữ cảnh 10 triệu token đều vừa một GPU đó.
Llama 4 Maverick
Các thông số công bố của Maverick gồm:
- 17B tham số hoạt động
- 400B tổng tham số
- 128 expert
- Cửa sổ ngữ cảnh tối đa 1 triệu token
- Đầu vào gồm văn bản và hình ảnh
- Đầu ra gồm văn bản và mã nguồn
Maverick có nhiều expert và tổng weights lớn hơn Scout, hướng tới trợ lý đa phương thức và tác vụ cần chất lượng cao. Hãy so trên cùng dữ liệu và hệ phục vụ để biết mức cải thiện có xứng với tài nguyên hay không.
17B active phản ánh phần tham gia tính toán cho mỗi token, không phải lượng weights cần lưu. Maverick có khoảng 400B tổng tham số; cấu hình FP8 được Meta mô tả trên máy chủ DGX H100 nhiều GPU, khác xa một card H100 đơn lẻ.
Llama 4 Behemoth
Meta giới thiệu bản xem trước Behemoth với cấu hình:
- 288B tham số hoạt động
- 16 expert
- Gần 2 nghìn tỷ tổng tham số
- Kiến trúc MoE đa phương thức
Behemoth đóng vai trò teacher trong quá trình huấn luyện Scout và Maverick. Các con số xem trước không phải thông số của một checkpoint đã được người dùng tải và kiểm chứng độc lập.
Đến thời điểm đối chiếu, chưa xác minh được weights Behemoth công khai trong danh mục Meta. Vì vậy, không đưa nó vào kế hoạch triển khai như một model sẵn có.
So sánh chi tiết các kích thước model của Llama: “Size” không phải là tất cả
Ký hiệu B biểu thị tỷ tham số. Chất lượng và chi phí còn phụ thuộc kiến trúc, lượng dữ liệu huấn luyện, cách hậu huấn luyện, độ dài prompt và phần mềm phục vụ.
Trước khi so hai model Llama, hãy đặt cạnh nhau các yếu tố:
- Thế hệ model
- Kiến trúc Dense hay MoE
- Số tham số hoạt động
- Tổng số tham số
- Cửa sổ ngữ cảnh
- Khả năng xử lý hình ảnh
- Định dạng Base hay Instruct
- Mức lượng tử hóa khi triển khai
Model Dense và model MoE khác nhau như thế nào?
Model dense như Llama 3.1 sử dụng gần như toàn bộ mạng cho mỗi token. Khi tăng kích cỡ, cả bộ nhớ weights lẫn khối lượng tính toán thường tăng.
MoE như Llama 4 chọn một phần expert cho từng token. Điều này tiết kiệm phép tính so với dense cùng tổng quy mô, nhưng weights của những expert còn lại vẫn phải nằm trong hệ thống phục vụ.
Ví dụ, Maverick có khoảng 17B active nhưng tổng cộng khoảng 400B. Không thể dùng yêu cầu VRAM của model dense 17B để suy ra cấu hình chạy Maverick; còn phải tính cache, routing và trao đổi dữ liệu giữa GPU.
Bảng so sánh các kích thước model Llama quan trọng
| Kích thước hoặc model | Loại dữ liệu | Ngữ cảnh | Mức tài nguyên | Nhu cầu phù hợp |
|---|---|---|---|---|
| Llama 3.2 1B | Văn bản | 128K | Rất thấp | Phân loại, viết lại, tóm tắt ngắn, AI trên thiết bị |
| Llama 3.2 3B | Văn bản | 128K | Thấp | Trợ lý local, gọi công cụ đơn giản, xử lý nội dung cá nhân |
| Llama 3.1 8B | Văn bản | 128K | Trung bình | Thử nghiệm local, chatbot nhỏ, fine-tune, RAG cơ bản |
| Llama 3.2 11B Vision | Văn bản và hình ảnh | 128K | Trung bình đến cao | Đọc ảnh, tài liệu, biểu đồ và ảnh chụp màn hình |
| Llama 3.3 70B | Văn bản | 128K | Cao | Chatbot doanh nghiệp, RAG, lập trình, phân tích chuyên sâu |
| Llama 3.2 90B Vision | Văn bản và hình ảnh | 128K | Rất cao | Phân tích hình ảnh phức tạp, tài liệu chuyên ngành |
| Llama 3.1 405B | Văn bản | 128K | Cực cao | R&D, dữ liệu tổng hợp, chưng cất model, suy luận chuyên sâu |
| Llama 4 Scout | Văn bản và hình ảnh | 10M | Cao | Ngữ cảnh cực dài, nhiều tài liệu, kho code lớn, multimodal |
| Llama 4 Maverick | Văn bản và hình ảnh | 1M | Rất cao | Trợ lý đa phương thức chất lượng cao, lập trình, doanh nghiệp |
| Llama 4 Behemoth | Đa phương thức | Chưa công bố đầy đủ | Chưa thể triển khai công khai | Model giáo viên, nghiên cứu quy mô cực lớn |
Thông số theo kho llama-models chính thức và model card Llama 4, đối chiếu. Mức ngữ cảnh là giới hạn model công bố, không phải bảo đảm hiệu quả trên mọi hệ phục vụ.
Ước tính dung lượng trọng số theo kích thước
Có thể lấy số tham số nhân số byte mỗi tham số để ước lượng phần weights trước:
- BF16 hoặc FP16: khoảng 2 byte cho mỗi tham số
- INT8 hoặc FP8: khoảng 1 byte cho mỗi tham số
- INT4: khoảng 0,5 byte cho mỗi tham số
| Quy mô model | BF16/FP16 | INT8/FP8 | INT4 |
|---|---|---|---|
| 1B | Khoảng 2GB | Khoảng 1GB | Khoảng 0,5GB |
| 3B | Khoảng 6GB | Khoảng 3GB | Khoảng 1,5GB |
| 8B | Khoảng 16GB | Khoảng 8GB | Khoảng 4GB |
| 11B | Khoảng 22GB | Khoảng 11GB | Khoảng 5,5GB |
| 70B | Khoảng 140GB | Khoảng 70GB | Khoảng 35GB |
| 90B | Khoảng 180GB | Khoảng 90GB | Khoảng 45GB |
| 405B | Khoảng 810GB | Khoảng 405GB | Khoảng 203GB |
Bảng chỉ ước lượng weights. Lượng tử hóa còn có scale và metadata; lúc chạy cần thêm KV cache, bộ đệm backend và bộ nhớ cho người dùng đồng thời. Context dài có thể chiếm phần lớn tài nguyên.
Cách chọn model Llama phù hợp cho từng nhu cầu
Bắt đầu từ chất lượng cần đạt, đầu vào văn bản hay ảnh, độ trễ, ngân sách và phần cứng. Các gợi ý dưới đây là điểm khởi đầu để thử nghiệm, không phải cam kết một model luôn tốt nhất.
Chạy AI trên điện thoại hoặc thiết bị biên
Các model nên đưa vào vòng thử:
- Llama 3.2 1B
- Llama 3.2 3B
Bản 1B tiết kiệm tài nguyên hơn cho nhiệm vụ đơn giản; bản 3B có thể phù hợp khi cần thêm khả năng hội thoại hoặc tóm tắt. Chất lượng phụ thuộc dữ liệu và cách đóng gói ứng dụng.
Xử lý trực tiếp trên thiết bị giúp giảm việc gửi nội dung ra ngoài, nhưng vẫn phải kiểm tra telemetry, plugin và các dịch vụ đi kèm để hiểu dữ liệu thực sự được truyền đi đâu.
Thử nghiệm local trên máy tính cá nhân
Các lựa chọn để bắt đầu trên máy cá nhân:
- Llama 3.1 8B Instruct
- Llama 3.2 3B Instruct nếu phần cứng hạn chế
- Llama 3.2 11B Vision nếu cần xử lý hình ảnh
Llama 3.1 8B có thể dùng làm điểm xuất phát cho chatbot local, RAG nhỏ hoặc LoRA. Ở mức 4-bit, riêng weights có quy mô vài GB; bộ nhớ chạy thật cao hơn và phụ thuộc bản đóng gói, ngữ cảnh cùng backend.
Xây dựng chatbot hoặc trợ lý AI cho doanh nghiệp
Các model có thể so sánh cho ứng dụng doanh nghiệp:
- Llama 3.3 70B cho hệ thống chỉ xử lý văn bản
- Llama 4 Scout cho ngữ cảnh dài hoặc kết hợp hình ảnh
- Llama 4 Maverick khi ưu tiên chất lượng tổng thể
Có thể so 3.3 70B với Scout/Maverick trên tập câu hỏi nội bộ, yêu cầu trích dẫn và các lần gọi công cụ. Scout có lợi thế về ngữ cảnh công bố, trong khi lựa chọn cuối vẫn phải tính độ chính xác, latency và chi phí vận hành.
Xử lý tài liệu, hình ảnh và biểu đồ
Các model nên thử khi có đầu vào thị giác:
- Llama 3.2 11B Vision cho nhu cầu vừa phải
- Llama 3.2 90B Vision cho phân tích hình ảnh chuyên sâu
- Llama 4 Scout cho tài liệu dài và nhiều hình ảnh
- Llama 4 Maverick cho chất lượng đa phương thức cao hơn
Llama 4 tích hợp đa phương thức từ huấn luyện nền, còn 3.2 Vision có thể phù hợp với hệ thống đã tối ưu cho Llama 3.x. Đánh giá riêng OCR, biểu đồ và ảnh nhiều chữ; không suy chất lượng đọc tài liệu từ điểm hội thoại chung.
Xử lý ngữ cảnh cực dài
Giới hạn ngữ cảnh công bố ở các nhóm chính:
- Llama 4 Scout: tối đa 10 triệu token
- Llama 4 Maverick: tối đa 1 triệu token
- Llama 3.1, 3.2 hoặc 3.3: tối đa 128K token
Scout có thể được đánh giá cho những công việc như:
- Tóm tắt nhiều tài liệu
- Đọc kho mã nguồn lớn
- Phân tích lịch sử hội thoại dài
- Tổng hợp hồ sơ hoặc dữ liệu theo thời gian
- Tìm kiếm thông tin trong tập tài liệu lớn
Không cần lấp đầy cửa sổ ngữ cảnh trong mọi lần gọi. Prompt rất dài tăng thời gian prefill, cache và chi phí, đồng thời có thể làm model bỏ sót thông tin. Với RAG, truy xuất đúng đoạn thường thực tế hơn gửi toàn bộ kho dữ liệu.
Xây dựng ứng dụng AI bằng tiếng Việt
Các lựa chọn đáng thử cho tiếng Việt:
- Llama 4 Scout
- Llama 4 Maverick
Model card Llama 4 liệt kê tiếng Việt trong nhóm ngôn ngữ được hỗ trợ. Danh sách hỗ trợ chính thức của Llama 3.3 gồm tám ngôn ngữ và không có tiếng Việt; điều này khác với việc model có thể tạo ra một ít văn bản tiếng Việt.
Vì thế, nên đưa Scout và Maverick vào phép thử tiếng Việt. Đo riêng dấu tiếng Việt, thuật ngữ ngành, cách xưng hô, trích xuất dữ liệu và tuân thủ chỉ dẫn trên bộ ví dụ thực tế.
Hỗ trợ lập trình và phân tích mã nguồn
Các hướng lựa chọn cho công việc phần mềm:
- Llama 3.1 8B cho thử nghiệm local
- Llama 3.3 70B cho chất lượng tốt ở tác vụ chỉ dùng văn bản
- Llama 4 Scout cho kho mã nguồn lớn
- Llama 4 Maverick cho lập trình và suy luận phức tạp
Code Llama vẫn có chỗ trong hệ thống cũ hoặc bài toán fill-in-the-middle. Với pipeline mới, cần so cùng các model hiện hành thay vì chọn theo chữ “Code” trong tên.
Tự lưu trữ để kiểm soát dữ liệu
Điểm xuất phát tùy tài nguyên:
- Máy tính cá nhân: Llama 3.2 1B, 3B hoặc Llama 3.1 8B đã lượng tử hóa
- Máy chủ một hoặc vài GPU: Llama 3.1 8B, Llama 3.3 70B đã lượng tử hóa
- GPU H100 80GB: Llama 4 Scout Int4
- Máy chủ H100 DGX: Llama 4 Maverick FP8
- Cụm GPU lớn: Llama 3.1 405B
Tự host cho phép kiểm soát weights, log và phiên bản, đổi lại phải quản lý cập nhật, truy cập, sao lưu và giám sát. Guard model chỉ là một lớp hỗ trợ, không thay thế kiểm soát quyền công cụ và bảo vệ dữ liệu.
Xem local model là gì cho hướng chạy bằng công cụ local và các LLM open-weight để so hệ sinh thái. Máy chỉ có CPU nên bắt đầu bằng model nhỏ, đo độ trễ trước khi mở nhiều người dùng.
Fine-tuning model theo dữ liệu riêng
Các checkpoint có thể thử cho fine-tuning:
- Llama 3.2 1B hoặc 3B cho thử nghiệm chi phí thấp
- Llama 3.1 8B cho LoRA hoặc QLoRA
- Llama 3.1 70B khi có hạ tầng mạnh
- Llama 4 Scout cho ứng dụng đa phương thức hoặc ngữ cảnh dài
Nên bắt đầu từ model nhỏ và dữ liệu sạch để kiểm chứng mục tiêu huấn luyện. Một adapter tốt có thể giúp tác vụ hẹp, nhưng phải so với prompt và RAG để biết fine-tuning có thực sự cần thiết.
Maverick hoặc 405B đòi hỏi hạ tầng và chuyên môn đáng kể. Đừng lấy cấu hình suy luận làm cấu hình huấn luyện vì optimizer, gradient và activation cần thêm bộ nhớ.
Nghiên cứu, tạo dữ liệu tổng hợp và chưng cất model
Các model có thể dùng cho nghiên cứu theo điều kiện giấy phép:
- Llama 3.1 405B
- Llama 4 Maverick
- Llama 4 Scout nếu cần ngữ cảnh dài
Model lớn có thể tạo dữ liệu tổng hợp hoặc làm teacher, nhưng dữ liệu sinh vẫn cần lọc và đánh giá. Khi dùng đầu ra để huấn luyện model khác, phải đọc các điều khoản áp dụng, bao gồm yêu cầu đặt tên và phân phối nếu có.
Behemoth chưa có weights được xác minh, nên chỉ nhắc như thông tin nghiên cứu được công bố.
Bảng gợi ý chọn model Llama nhanh
| Nhu cầu | Model nên cân nhắc |
|---|---|
| Chạy trên điện thoại hoặc edge | Llama 3.2 1B hoặc 3B |
| Chạy local trên máy tính | Llama 3.1 8B |
| Chatbot doanh nghiệp chỉ dùng văn bản | Llama 3.3 70B |
| Chatbot hoặc AI Agent tiếng Việt | Llama 4 Scout hoặc Maverick |
| Đọc ảnh và tài liệu | Llama 3.2 11B Vision hoặc Llama 4 Scout |
| Phân tích hình ảnh chuyên sâu | Llama 3.2 90B Vision hoặc Llama 4 Maverick |
| Xử lý kho tài liệu, code rất lớn | Llama 4 Scout |
| Chất lượng đa phương thức cao | Llama 4 Maverick |
| Fine-tuning tiết kiệm | Llama 3.2 3B hoặc Llama 3.1 8B |
| R&D và dữ liệu tổng hợp | Llama 3.1 405B |
| Hệ thống cũ dùng Llama 2 | Llama 2 hoặc Code Llama tương ứng |
Llama 3.1 8B là điểm bắt đầu dễ tiếp cận hơn cho local; 3.3 70B là ứng viên văn bản; Scout và Maverick phục vụ các yêu cầu đa phương thức hoặc ngữ cảnh dài hơn. Đây là cách phân loại để chọn model thử nghiệm, không phải bảng xếp hạng tuyệt đối.
Hãy đo trên cùng prompt, retrieval, công cụ và tiêu chí đầu ra. Model nhỏ với dữ liệu tốt có thể hiệu quả hơn một model lớn đặt trong pipeline truy xuất hoặc xử lý lỗi kém.
Kết luận
Hiểu đúng đời model, tổng tham số, active parameters và giấy phép sẽ giúp chọn được cấu hình Llama phù hợp. Tải weights đem lại thêm quyền kiểm soát hạ tầng, đồng thời yêu cầu người triển khai tự chịu trách nhiệm về vận hành, dữ liệu và điều kiện sử dụng.
Câu hỏi thường gặp
Llama là con gì? Vì sao model của Meta tên Llama?
Llama là tên loài lạc đà không bướu ở Nam Mỹ. Tên mô hình bắt nguồn từ chữ viết tắt LLaMA, tức Large Language Model Meta AI; cách đọc gần tên loài vật tạo nên biểu tượng quen thuộc của dòng model.
Tôi có thể sử dụng Llama cho mục đích thương mại không?
Nhiều phiên bản từ Llama 2 cho phép dùng thương mại theo Community License và Acceptable Use Policy. Đây không phải quyền vô điều kiện: có yêu cầu ghi nhận, phân phối, các giới hạn sử dụng và điều khoản riêng cho tổ chức vượt ngưỡng 700 triệu người dùng hoạt động hàng tháng theo cách tính trong giấy phép. Đọc đúng bản license của checkpoint trước khi triển khai.
Tôi nên chọn Llama 2, Llama 3 hay Llama 4?
Với dự án mới, thử Llama 4 khi cần tiếng Việt, ảnh hoặc ngữ cảnh dài; cân nhắc Llama 3.1/3.2 nhỏ cho local và 3.3 70B cho văn bản. Llama 2 hoặc Code Llama phù hợp hơn khi cần tương thích hệ thống cũ. Chọn sau khi đo chất lượng và tài nguyên, đồng thời đọc giấy phép riêng của bản đó.
Vì sao model ít tham số hơn đôi khi đạt điểm cao hơn model cũ lớn hơn?
Số tham số chỉ là một yếu tố. Dữ liệu, tokenizer, kiến trúc và hậu huấn luyện có thể giúp model nhỏ đời sau vượt một bản lớn đời trước ở một số bài đánh giá. Không nên suy từ đó rằng Llama 3 8B mạnh hơn Llama 2 70B trong mọi trường hợp; hãy nêu rõ bài test và cấu hình.
Llama Guard có phải là một model AI không? Dùng để làm gì?
Llama Guard là model phân loại an toàn chuyên biệt, không phải trợ lý hỏi đáp tổng quát. Danh mục có Guard 3 với các bản 1B/8B và Guard 4 12B. Có thể dùng để kiểm tra đầu vào hoặc đầu ra theo taxonomy rủi ro, kết hợp bộ kiểm thử và quy trình xử lý sai phân loại.
Kiến trúc MoE (Mixture of Experts) trên Llama 4 có nghĩa là gì?
MoE chia mạng thành các expert và định tuyến từng token qua một phần trong số đó. Nó giảm khối lượng tính toán hoạt động so với dense cùng tổng quy mô, nhưng hệ phục vụ vẫn phải chứa hoặc phân phối toàn bộ weights. Vì vậy, Maverick 400B không có yêu cầu bộ nhớ của model dense 17B.
Xem thêm cụm bài về model AI và các lựa chọn API để chọn cách sử dụng phù hợp.